Prompt Engineering ガイド 第9回(全10回)。応用編です。第1〜6回の基礎を前提にしています。初めての方は 第1回:プロンプトエンジニアリングとは何か、なぜ重要か からどうぞ。
AI コーディングアシスタントは、それらしいコードを数秒で書きます。そのコードが本当に動くかどうかは、ほとんどプロンプトで決まります。言語のバージョン、守るべきルール、エラーメッセージ、そして結果をどう確かめるか。本記事では、開発者が毎日行う作業(生成、解説、デバッグ、リファクタリング、言語移植、テスト、レビュー)ごとに、コピーしてすぐ使えるAI コーディングアシスタント向けプロンプトを出力例付きで紹介します。
どのプロンプトも ChatGPT、Claude、Gemini、IDE のチャット欄で使えます。後半ではコーディングエージェントと検証を扱います。プロンプトは プロンプトの 5 つの構成要素 を土台にしているので、用語が初めての方は先にそちらをご覧ください。
願望ではなく仕様からコードを生成する
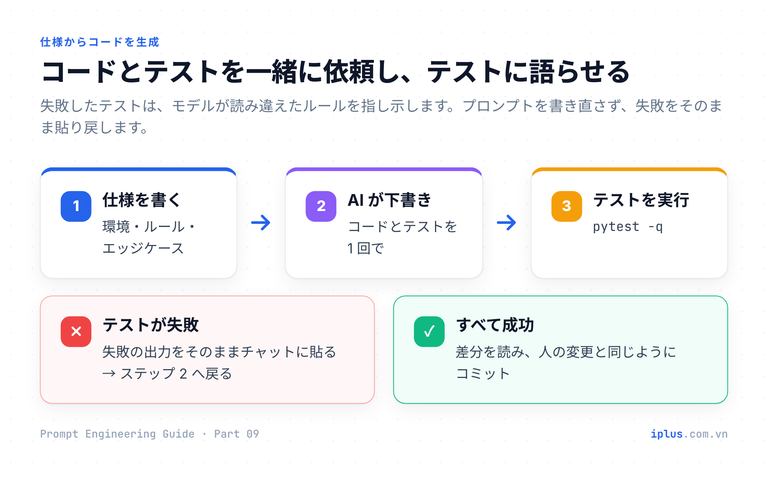
「営業日数を数える関数を書いて」では、バージョン、両端を含むか、祝日、不正な入力をモデルが推測するしかなく、推測はバグの種になります。プロンプトは小さなチケットのように書きます。環境、シグネチャ、ルール、エッジケース、そして推測を確かめるためのテストを同じ返答で依頼します。
あなたはシニア Python 開発者です。

環境:Python 3.12、標準ライブラリのみ。
タスク:次のシグネチャの関数を書いてください。
    business_days_between(start: date, end: date, holidays: Iterable[date] = ()) -> int

ルール:
- start から end までの月曜〜金曜を数える。両端の日付を含む。
- holidays に含まれる日は除外する。週末に重なる祝日は結果に影響しない。
- start が end より後なら ValueError を送出する。

エッジケース:同じ日、週末だけの期間、週末に重なる祝日。
出力:1)docstring と型ヒント付きの関数、
2)すべてのルールとエッジケースを網羅する pytest のテスト。それ以外の説明は不要。# workdays.py
from collections.abc import Iterable
from datetime import date, timedelta
def business_days_between(
start: date, end: date, holidays: Iterable[date] = ()
) -> int:
"""Count weekdays (Mon-Fri) from start to end, inclusive, minus holidays."""
if start > end:
raise ValueError("start must be on or before end")
holiday_set = set(holidays)
count = 0
current = start
while current <= end:
if current.weekday() < 5 and current not in holiday_set:
count += 1
current += timedelta(days=1)
return count
# test_workdays.py
from datetime import date
import pytest
from workdays import business_days_between
def test_full_week_counts_five_days():
assert business_days_between(date(2026, 10, 19), date(2026, 10, 25)) == 5
def test_weekday_holiday_is_skipped():
culture_day = date(2026, 11, 3) # Tuesday
assert business_days_between(date(2026, 11, 2), date(2026, 11, 8), [culture_day]) == 4
def test_start_after_end_raises():
with pytest.raises(ValueError):
business_days_between(date(2026, 10, 25), date(2026, 10, 19))
# (trimmed: same-day, weekend-only and weekend-holiday tests)出力例:文言は実行ごと・モデルごとに変わります
2 つのファイルを保存して pytest を実行すると 6 passed と表示されるはずです。失敗したら出力をそのまま貼り戻しましょう。読み違えたルールが伝わります。
汎用テンプレートです。{…} を自分の内容に置き換えてください。
あなたはシニア {言語} 開発者です。

環境:{言語とバージョン}、{使ってよいフレームワーク・ライブラリ}
タスク:{作るもの}。シグネチャ:{シグネチャ}

ルール:
- {ルール 1}
- {ルール 2}

エッジケース:{列挙する}
出力:コード、続いてすべてのルールとエッジケースを網羅する {テストフレームワーク} のテスト。
ポイント:ルールは 1 行ずつ書きます。長い文に埋もれた条件は見落とされます。
見慣れないコードを解説させ、コメントを付ける
「ジュニア開発者向け」のように読み手を指定すると説明の深さが合います。「説明」と「変更」は分け、コードを変えずにコメントだけ追加させればレビューが簡単です。
次の TypeScript 関数を、ジュニア開発者向けに解説してください。
1. 何をする関数かを一文で。
2. 1 行ずつ説明し、使われている言語機能の名前を挙げる。
3. 使用例を 1 つ、出力付きで。
4. TSDoc コメントを追加した同じコードを返す。コード自体は一切変更しない。

<code>
export const groupBy = <T, K extends PropertyKey>(items: T[], key: (item: T) => K) =>
  items.reduce((acc, item) => {
    (acc[key(item)] ||= []).push(item)
    return acc
  }, {} as Record<K, T[]>)
</code>何をするか:配列を key 関数の値ごとにまとめたオブジェクトに変換します。
たとえばサポートチケットをステータス別にまとめます。
1 行ずつ:
- <T, K extends PropertyKey>:ジェネリクス。K はオブジェクトのキーに
使える型(string | number | symbol)に制限されます。
- items.reduce(..., {} as Record<K, T[]>):各要素を空の
「キー → 要素」オブジェクトに畳み込みます。
- (acc[key(item)] ||= []):論理和代入(ES2021)。グループの配列が
なければ作り、その配列を返します。
- .push(item); return acc:要素を追加し、オブジェクトを次へ渡します。
使用例:
groupBy(tickets, (t) => t.status)
// {"open":[{"id":1,...},{"id":3,...}],"closed":[{"id":2,...}]}出力例:文言は実行ごと・モデルごとに変わります
デバッグには要約ではなくエラー全文を渡す
「動きません」ではモデルは推測するしかありません。答えられるデバッグ用プロンプトには 5 つの情報が必要です。コード、スタックトレースを含むエラー全文、実行環境、期待した動作と実際の動作、すでに試したこと。修正案より先に根本原因を答えさせると、パッチだけでなく推論そのものを評価できます。
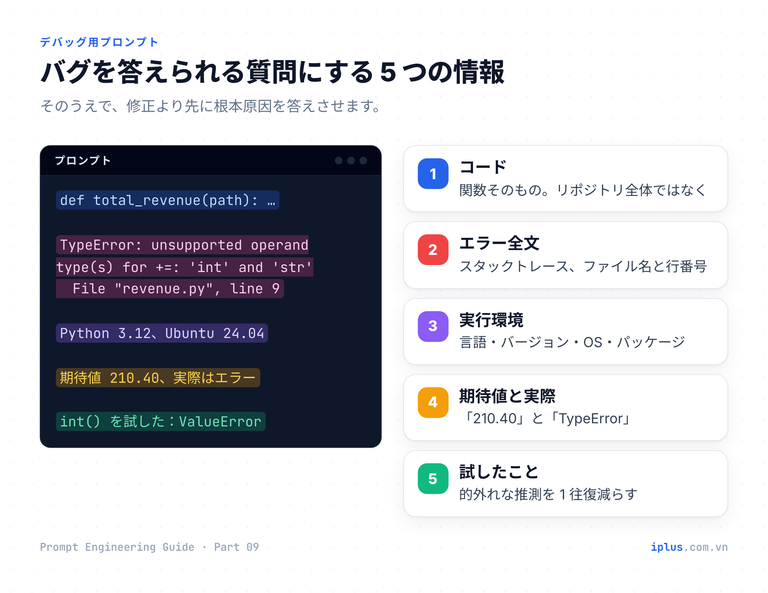
修正案を出す前に、このバグの根本原因を特定してください。

コード(revenue.py):
import csv


def total_revenue(path):
    total = 0
    with open(path, newline="") as f:
        for row in csv.DictReader(f):
            if row["status"] == "paid":
                total += row["amount"]
    return total


print(total_revenue("orders.csv"))

入力ファイル(orders.csv):
order_id,status,amount
1001,paid,120.50
1002,refunded,40.00
1003,paid,89.90

エラー:
Traceback (most recent call last):
  File "/app/revenue.py", line 13, in <module>
    print(total_revenue("orders.csv"))
  File "/app/revenue.py", line 9, in total_revenue
    total += row["amount"]
TypeError: unsupported operand type(s) for +=: 'int' and 'str'

環境:Ubuntu 24.04 上の Python 3.12、サードパーティパッケージなし。
期待値:210.40(支払済み注文の合計)。実際:上記のエラー。
試したこと:値を int() で囲んだが、"120.50" で ValueError になった。

回答形式:1)根本原因を 2 文で、2)最小限の修正、3)この関数にある他のバグ。1)根本原因:csv.DictReader はすべての値を文字列で返すため、
row["amount"] は数値ではなく "120.50" です。int 型の total に str は
足せないので TypeError になります。"120.50" は整数リテラルではない
ため int() も失敗します。
2)最小限の修正:金額を Decimal で読み込みます。銭単位まで正確です。
from decimal import Decimal
...
total = Decimal("0")
...
total += Decimal(row["amount"])
結果:210.40(float は入力により誤差が出ます。0.1 + 0.2 は
0.30000000000000004 で、金額には不適切)
3)その他のリスク:row["status"] == "paid" は "Paid "(大文字・空白)を
黙って除外します。row["status"].strip().lower() を検討してください。出力例:文言は実行ごと・モデルごとに変わります
動作を変えずにリファクタリング・最適化・言語移植する
AI の「より速い」コードは、実は遅かったり動作が微妙に違ったりします。厳密な制約(同じシグネチャ、同じ出力順、依存追加なし)を与え、自分で実行できる証拠、つまり旧版との同値性テストとベンチマークを求めましょう。
遅い関数を最適化し、証拠も出させる
この Python 3.12 の関数を最適化してください。メール 5,000 件で約 1 秒かかり、
件数が 2 倍になるたびに 4 倍遅くなります。

def find_duplicate_emails(emails):
    duplicates = []
    for i, email in enumerate(emails):
        for other in emails[i + 1:]:
            if email.lower() == other.lower() and email.lower() not in duplicates:
                duplicates.append(email.lower())
    return duplicates

制約:
- シグネチャも出力も完全に同じ(順序を含む)。
- 標準ライブラリのみ。
続けて bench_dupes.py を書いてください。(1)ランダムなデータとエッジケースで
新旧の結果が一致することを assert し、(2)両方の実行時間を測る。
最適化前後の計算量も示してください。計算量:元のコードは全ペアを比較するため O(n²) の文字列比較に加え、
リスト duplicates の線形探索があります。以下の版は O(n) です。
from collections import Counter
def find_duplicate_emails(emails: list[str]) -> list[str]:
"""Return lowercased emails that appear more than once, in first-seen order."""
counts = Counter(email.lower() for email in emails)
seen: set[str] = set()
result: list[str] = []
for email in emails:
key = email.lower()
if counts[key] > 1 and key not in seen:
seen.add(key)
result.append(key)
return result
# bench_dupes.py (trimmed); the original is kept as find_duplicate_emails_old
emails = [f"user{random.randint(0, 3000)}@Example.com" for _ in range(5000)]
for case in (emails, [], ["[email protected]"], ["[email protected]", "[email protected]", "[email protected]", "[email protected]"]):
assert find_duplicate_emails(case) == find_duplicate_emails_old(case)
old = timeit.timeit(lambda: find_duplicate_emails_old(emails), number=1)
new = timeit.timeit(lambda: find_duplicate_emails(emails), number=1)
print(f"old: {old:.3f}s new: {new:.4f}s speed-up: {old / new:.0f}x")出力例:文言は実行ごと・モデルごとに変わります
筆者の環境(Python 3.14、メール 5,000 件)では old: 0.893s new: 0.0013s speed-up: 666x と表示されました。数値は環境で変わります。大事なのは、同じ答えを返すことを証明する assert です。
言語間でコードを移植する
機械的な移植はコンパイルが通っても、言語仕様が異なる箇所(丸め、整数除算、数値の範囲、日付)で動作が変わります。動作の維持、仕様の違いの列挙、違いが表れる入力でのテストを求めましょう。
この JavaScript を Python 3.12 に移植してください。丸めや数値の扱いを含め、
動作を完全に維持すること。対処が必要だった両言語の仕様の違いをすべて挙げ、
単純な移植では結果が変わってしまう入力のテストケースを 3 つ示してください。

function lineTotal(unitPriceCents, qty, discountPct) {
  const gross = unitPriceCents * qty;
  const discount = Math.round((gross * discountPct) / 100);
  return gross - discount;
}import math
def js_round(x: float) -> int:
"""Match JavaScript Math.round: halves round up (toward +infinity)."""
return math.floor(x + 0.5)
def line_total(unit_price_cents: int, qty: int, discount_pct: float) -> int:
gross = unit_price_cents * qty
discount = js_round(gross * discount_pct / 100)
return gross - discount
対処した仕様の違い:
1. 丸め:Math.round は 0.5 を切り上げ(2.5 → 3)、Python の round() は
偶数への丸め(2.5 → 2)。js_round() で JS の動作を再現します。
2. 数値の範囲:JS の整数が正確なのは 2^53 - 1 まで、Python の int は
上限なし。現実的な価格なら結果は同じです。
テストケース(unit_price_cents, qty, discount_pct → 期待値):
- (125, 1, 2) → 122 単純な round() では 123 になる
- (1999, 3, 10) → 5397
- (350, 1, 5) → 332出力例:文言は実行ごと・モデルごとに変わります
実行すると JavaScript と移植後の Python はどちらも 122 5397 332 を返し、round() による単純な移植は最初のケースで 123、つまり明細 1 行あたり 1 セントのバグになりました。
落とし穴 | JavaScript | Python | Java |
|---|---|---|---|
0.5 の丸め |
|
|
|
整数の除算 |
|
|
|
負数の剰余 |
|
|
|
大きな整数 | 2^53 − 1 まで正確 | 上限なしの int | 64 ビット long はオーバーフロー |
月の番号 |
|
|
|
複数ファイルのコンテキストを整理して渡す
関係するファイルだけを、パス付きのタグで包んで貼ります。ファイルを先に、タスクを最後に。Anthropic は、長い入力の後に質問を置くと回答品質が最大 30% 向上すると報告しています。さらに「止まる許可」を与えれば、架空の import を防げます。
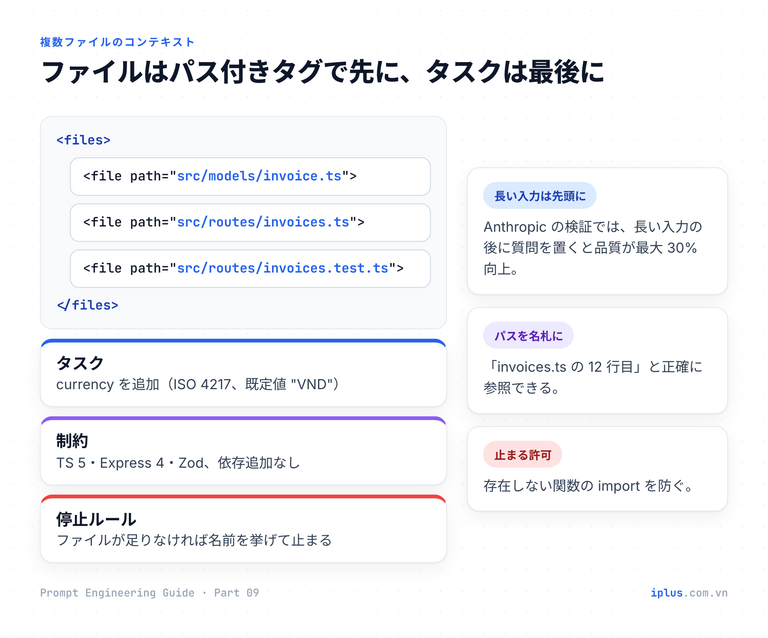
<files>
<file path="src/models/invoice.ts">
{ファイルの内容}
</file>
<file path="src/routes/invoices.ts">
{ファイルの内容}
</file>
<file path="src/routes/invoices.test.ts">
{ファイルの内容}
</file>
</files>

タスク:請求書に任意項目 currency(ISO 4217 コード、既定値 "VND")を追加する。
POST /invoices で受け取り、検証し、レスポンスに含める。
制約:TypeScript 5、Express 4、Zod。依存の追加なし。既存テストは通ったままにする。
コードを書く前に、変更するファイルと理由を挙げること。含まれていないファイルが
必要なら、その名前を挙げて止まること。
その後、各変更を unified diff で示すこと。
{ファイルの内容} を実際のファイル内容に置き換えてください。典型的な最初の返答はこうなります。
変更計画
1. src/models/invoice.ts:Invoice 型に currency: string を追加し、
   createInvoice() で既定値 "VND" を設定する。
2. src/routes/invoices.ts:Zod スキーマに
   currency: z.string().regex(/^[A-Z]{3}$/).default("VND") を追加する。
3. src/routes/invoices.test.ts:既定値が入ること、"USD" が通ること、
   "vnd" と "VNDX" が 400 になることをテストする。

不足しているコンテキスト:invoices.ts は INSERT を組み立てる
src/db/invoices.ts の saveInvoice を import しており、テーブルには
マイグレーションも必要です。diff の前に src/db/invoices.ts と
マイグレーションの構成を共有してください。
出力例:文言は実行ごと・モデルごとに変わります
本当のバグを捕まえるユニットテストとコードレビュー
ユニットテストを生成する
まず振る舞いを列挙させ、次にテストを書かせます。フレームワークを指定し、テスト対象そのもののモック化を禁止します(何も検証しないテストの典型的な原因です)。実行後、一度わざと関数を壊して失敗することも確認します。
次の関数の pytest テストを書いてください。
まず、網羅する振る舞いとエッジケースを 1 行ずつ列挙すること。
その後でテストを書くこと:
- 似たケースは @pytest.mark.parametrize でまとめる
- mask_email 自体はモックしない
- ValueError を送出すべき不正な入力も含める

def mask_email(email: str) -> str:
    """Keep the first character of the local part, mask the rest: j***@example.com."""
    local, sep, domain = email.strip().partition("@")
    if not sep or not local or not domain or "@" in domain:
        raise ValueError(f"not an email address: {email!r}")
return f"{local[0]}{'*' * (len(local) - 1)}@{domain.lower()}"振る舞い:先頭 1 文字以外をマスク、1 文字のローカル部は維持、ドメインは
小文字化、前後の空白を除去、不正なアドレスは拒否。
# test_masking.py
import pytest
from masking import mask_email
@pytest.mark.parametrize(
("email", "expected"),
[
("[email protected]", "j*******@example.com"),
("[email protected]", "[email protected]"), # one-character local part
("[email protected]", "J***@example.com"), # domain lowercased
# (trimmed: whitespace case)
],
)
def test_masks_valid_addresses(email, expected):
assert mask_email(email) == expected
@pytest.mark.parametrize(
"bad",
["", "no-at-sign", "@example.com", "john@", "a@[email protected]"],
)
def test_rejects_invalid_addresses(bad):
with pytest.raises(ValueError):
mask_email(bad)出力例:文言は実行ごと・モデルごとに変わります
完全版のファイルでは 9 passed になります。
重大度の基準を付けてコードレビューを依頼する
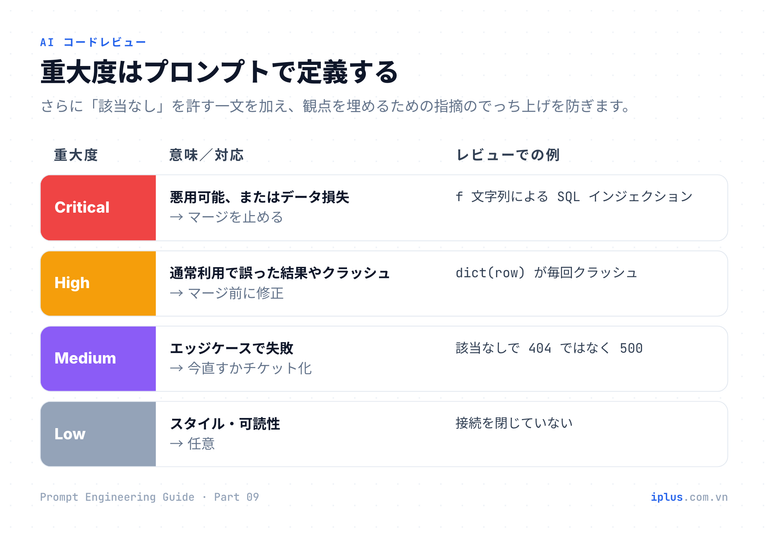
「レビューして」だけでは、スタイルの指摘と本当の欠陥が混ざります。観点と重大度を定義し、指摘ごとに行番号と修正案を求め、「該当なし」を許しましょう。これがないと、モデルは観点を埋めるために指摘をでっち上げがちです。
この Flask のエンドポイント(Python 3.12、SQLite)を、バグ・セキュリティ・
パフォーマンス・可読性の観点でレビューしてください。
重大度:Critical=悪用可能またはデータ損失、High=通常利用で誤った結果や
クラッシュ、Medium=エッジケースでの不具合、Low=スタイル。
表で返すこと:重大度 | 行 | 問題 | 修正案。重大度順に並べる。
問題のない観点は、推測せず「該当なし」と書くこと。

@app.get("/users")
def find_user():
    email = request.args.get("email")
    conn = sqlite3.connect("app.db")
    row = conn.execute(f"SELECT * FROM users WHERE email = '{email}'").fetchone()
return jsonify(dict(row))| 重大度 | 行 | 問題 | 修正案 |
|--------|----|------|--------|
| Critical | 5 | SQL インジェクション:email をクエリに直接埋め込んでおり、' OR '1'='1 でユーザーが返る | パラメータ化:conn.execute("SELECT ... WHERE email = ?", (email,)) |
| High | 5-6 | SELECT * でパスワードハッシュを含む全列がクライアントに返る | 公開してよい列(id, name, email)だけを選ぶ |
| High | 6 | dict(row) が失敗する:row_factory を設定しないと sqlite3 の行はタプル | conn.row_factory = sqlite3.Row を設定する |
| Medium | 6 | 該当なしだと None が返り、dict(None) で例外、API は 500 を返す | row が None なら 404 を返す |
| Medium | 3 | email パラメータがないと 'None' で検索してしまう | email がなければ 400 を返す |
| Low | 4 | 接続が閉じられない | with closing(sqlite3.connect(...)) を使う |
パフォーマンス:該当なし。出力例:文言は実行ごと・モデルごとに変わります
正規表現とシェルのワンライナーはテストケースとセットで
ワンライナーは密度が高く間違えやすく、方言(Python と JavaScript の正規表現、GNU と BSD のコマンド)も異なります。方言を明示し、説明と、一致する例・一致してはいけない例を求めましょう。
YYYY-MM-DD 形式の日付を検証する Python(re モジュール)のパターンを書いてください。
- パターンの各部分を説明する。
- 一致する文字列を 4 つ、一致してはいけない文字列を 4 つ挙げる。
- このパターンでは検査できないことと、その検査方法を述べる。パターン(re.fullmatch で使用):
[0-9]{4}-(0[1-9]|1[0-2])-(0[1-9]|[12][0-9]|3[01])
- [0-9]{4} 4 桁の年
- (0[1-9]|1[0-2]) 01〜12 月
- (0[1-9]|[12][0-9]|3[01]) 01〜31 日
一致: 2026-10-20、1999-01-01、2024-02-29、2026-12-31
不一致:2026-13-01、2026-00-10、2026-1-5、2026-10-32
検査できないこと:
- 月ごとの日数:2026-02-30 は通ります。date.fromisoformat() で検査します。
- \d ではなく [0-9] を使いました。Python の \d は全角の 2026 のような
ASCII 以外の数字にも一致します。
- re.match と ^...$ ではなく re.fullmatch を使ってください。$ は末尾の改行の
直前にも一致するため、"2026-10-20\n" が通ってしまいます。出力例:文言は実行ごと・モデルごとに変わります
各主張は Python で確認済みです(re モジュールのドキュメント参照)。こうした情報は「何を検査できないか」と聞いて初めて得られます。
/var/log 以下で、100 MB を超え、かつ過去 7 日以内に更新された .log ファイルを
サイズ付きで一覧するシェルコマンドをください。GNU(Linux)と BSD(macOS)の
どちらの find でも動くこと。何も削除しないこと。各オプションを説明すること。find /var/log -type f -name '*.log' -size +100M -mtime -7 -exec ls -lh {} +
-type f 通常ファイルのみ
-name '*.log' シェルが * を展開しないように引用符で囲む
-size +100M 100 MiB 超(GNU・BSD の find 両方で有効)
-mtime -7 7 日以内に更新
-exec ls -lh {} + サイズを表示。複数ファイルを 1 回の ls にまとめる出力例:文言は実行ごと・モデルごとに変わります
コーディングエージェント向けプロンプト:指示ファイルとタスク指示
コーディングエージェント(Claude Code、Cursor、GitHub Copilot、OpenAI Codex)は自らファイルを編集しコマンドを実行します。方向づけるプロンプトは 2 つ。1 つ目は毎セッション開始時に読み込まれる指示ファイルです。Claude Code は CLAUDE.md、Copilot は .github/copilot-instructions.md、Cursor は .cursor/rules、そしてオープンな形式の AGENTS.md は Codex、Cursor、Copilot が読み込みます(Claude Code も CLAUDE.md の代わりに読めます)。内容は短く、コマンド、規約、ガードレールだけに。
# AGENTS.md

## Commands
- Type-check: `pnpm typecheck` (must pass with zero errors)
- Lint: `pnpm lint` (zero warnings)
- Test: `pnpm vitest run`

## Conventions
- TypeScript strict mode. No `any` in new code.
- API handlers live in `src/app/api/`; validate every request body with Zod.
- Money is stored as integer minor units (cents/đồng), never floats.

## Guardrails
- Never edit files under `src/migrations/` by hand; generate them.
- Never commit secrets. Read config from environment variables.
- Ask before adding a dependency.
2 つ目はタスク指示です。ゴール、制約、コマンドで確認できる完了条件、止まって質問する条件をそろえます。
ゴール:POST /api/contact にレート制限を追加する。1 IP あたり 10 分間に
最大 5 リクエスト。6 回目は 429 と { success: false, error } を返す。

背景:Upstash Redis を既に使っている(src/lib/rate-limit.ts を参照)。
制約:そのヘルパーを再利用する。依存の追加なし。成功時のレスポンス形式は変えない。
完了条件:pnpm typecheck、pnpm lint、pnpm vitest run がすべて通り、
ウィンドウ内の 6 回目が 429 になることを新しいテストで証明する。
止まって質問する条件:ヘルパーで 10 分のウィンドウを表現できない場合、または
src/app/api/contact/ 以外の変更が必要に思える場合。完了しました。
- route.ts:検証前に rateLimit(ip, { limit: 5, window: "10 m" })、
超過時は 429 と { success: false, error } を返す。
- route.test.ts:同じ IP から 6 回送信 → [200 ×5, 429]。
チェック:typecheck エラー 0、lint 警告 0、vitest 48 件成功(新規 1 件)。出力例:文言は実行ごと・モデルごとに変わります
エンジニアが仕様を決めてレビューし、エージェントが実装する。この役割分担がiPlus の Claude Code × シニアエンジニアによる開発モデルの土台です。
すべてを検証する:AI のコーディング支援にできないこと
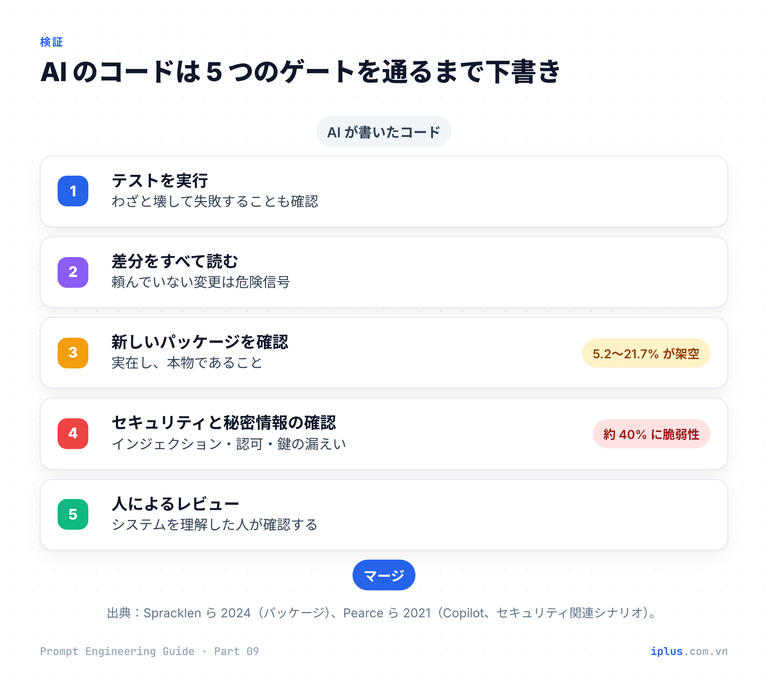
通常のチャットでは、実行ツールがない限りモデルはコードを実行しません。「Linux ターミナルとして振る舞って」の出力は作り話であり、推測であってテスト結果ではありません。検証が欠かせない理由は研究でも示されています。
- Pearce ら(2021)は、セキュリティ上重要なシナリオで GitHub Copilot に 1,689 本のプログラムを生成させ、約 40% に脆弱性を確認しました。
- Spracklen ら(2024)は 576,000 件のコードを分析し、提案されたパッケージのうち商用モデルの 5.2%、オープンソースモデルの 21.7% が実在しないことを示しました。攻撃者がその名前でマルウェアを登録できます。
- METR による 2025 年のランダム化比較試験では、経験豊富な OSS 開発者が AI ツールで 19% 遅くなりながら、20% 速くなったと感じていました。
モデルは進歩していますが、浮いた時間は確認に使うべきです。実行前に、モデル自身に弱点を挙げさせましょう。
このコードを実行する前に、次の点を挙げてください。
1. 入力・環境・バージョンについて置いたすべての前提
2. 使用したパッケージ・関数・API のうち、{言語/フレームワークとバージョン} に
   実在するか私が確認すべきもの
3. このコードを壊す可能性が最も高い入力を 3 つ1. 前提:UTF-8 の CSV でヘッダーあり、小数点は "."。
2. 確認すべきもの:csv.DictReader、decimal.Decimal(標準ライブラリ)。
3. 壊しやすい入力:"1,200.50"、空白付きの "Paid "、空の金額。出力例:文言は実行ごと・モデルごとに変わります
注意:シークレット、認証情報、顧客データは AI ツールに貼らないでください。{API_KEY} のようなプレースホルダーを使い、ソースコード共有に関する社内規定に従いましょう。
AI コーディング用プロンプトのよくある間違い
間違い | 何が起きるか | 代わりにすること |
|---|---|---|
言語やバージョンを書かない | 別のランタイム向けや廃止された API のコードになる | 「Python 3.12」「Node 22」「Spring Boot 3」と明記する |
「動きません」とだけ書く | モデルが原因を推測する | エラー全文、入力、期待値と実際の結果を貼る |
「最適化済み」のコードをそのまま採用 | 遅くなる、または微妙に動作が変わる | 同値性テストとベンチマークを求める |
リポジトリ全体を貼る | 肝心の行が埋もれる | 関係するファイルだけをパス付きタグで渡す |
シミュレーション出力を信じる | 「ターミナル」や「SQL」の結果は作り話 | 自分で実行するか、本物の実行ツールを使う |
提案されたパッケージをそのまま入れる | 実在しない、または悪意あるパッケージの可能性 | レジストリのページ、メンテナー、ダウンロード数を先に確認 |
シークレットや顧客データを貼る | 第三者への漏えい | プレースホルダーを使い、社内規定に従う |
よくある質問
AI コーディングアシスタントに最適なプロンプトは?
万能のプロンプトはありません。効くものは、環境、シグネチャ付きタスク、箇条書きのルール、エッジケース、テストを含む出力という構造を共有しています。冒頭の仕様テンプレートで大半をカバーできます。
AI はコードのバグを見つけられますか?
エラー全文、入力、期待値を渡せば多くの場合は見つけられます。苦手なのは DB の中身やタイミングなど、見えない実行時状態に依存するバグです。根本原因はテストで裏付けましょう。
会社のコードを ChatGPT や Claude に貼っても安全ですか?
社内規定とプランによります。法人向けや API は、無料プランとデータ保持・学習利用の条件が異なるのが一般的です。シークレットや個人情報は貼らないでください。
推論モデルでもデバッグに「ステップごとに考えて」は必要?
ほぼ不要です。推論モデルは回答前に考えます。今も効くのは、修正より先に根本原因を答えさせ、推論を確認可能にすることです。詳しくは 技法の組み合わせ をご覧ください。
参考資料
- Learn Prompting: Coding Assistance
- Pearce ら(2021): Asleep at the Keyboard?
- Spracklen ら(2024): コード生成 LLM のパッケージ幻覚
- METR(2025): AI と経験豊富な OSS 開発者の生産性
- Anthropic: Prompting best practices(長文コンテキストのプロンプト)
- Claude Code ドキュメント: How Claude remembers your project(CLAUDE.md、AGENTS.md)
- AGENTS.md: コーディングエージェント向けのオープンな形式
- GitHub Docs: Adding repository custom instructions for GitHub Copilot
- Cursor Docs: Rules
- Python ドキュメント: round()、MDN: Math.round()
Prompt Engineering ガイド 全記事
← 前の回:第8回:メール・ブログ・マーケティングのプロンプト · 次の回:第10回:ナレッジベース・チャットボット(RAG)の構築 →
第1〜6回は前の回を前提にしているため、順番にお読みください。第7〜10回は基礎を押さえた後なら、どの順番でも読めます。
この分野でお困りですか?
本記事に関連する iPlus Solution のサービスをご覧ください。