Prompt Engineering ガイド 第5回(全10回)。この回は 第4回:指示プロンプトとロールプロンプト の内容を前提にしています。初めての方は 第1回:プロンプトエンジニアリングとは何か、なぜ重要か からどうぞ。
指示だけでは足りない場面があります。サポートチケットに優先度を付けさせると、チームなら「low」と判断する軽い不具合に「normal」が付く。JSON を頼むと、毎回キー名が違う。こうした問題を解決するのがフューショット・プロンプティング(few-shot prompting)です。欲しいものを説明する代わりに、完成した例をいくつか見せて、そのパターンをモデルに真似させます。
この記事では、1 つの例題を使ってゼロショット・ワンショット・フューショットの違いを確認し、効果が特に大きい 3 つの用途(出力形式の制御、雑多なテキストからの情報抽出、自社ルールでの分類)に応用します。各セクションに ChatGPT・Claude・Gemini にそのまま貼れるプロンプトと、期待できる出力を載せています。
ゼロショット・ワンショット・フューショット・プロンプティングとは
大規模言語モデル(LLM)は、再学習をしなくても、プロンプト内に置かれた例からタスクを読み取れます。これをインコンテキスト学習(in-context learning)と呼びます。GPT-3 の論文 「Language Models are Few-Shot Learners」(Brown ら、2020 年)の中心的な発見です。例 1 つを「ショット」と数えるので、名前は単純に例の数を表しています。
手法 | プロンプト内の例 | 向いている用途 |
|---|---|---|
ゼロショット | 0 個(指示のみ) | ラベルが明確な一般的タスク |
ワンショット | 1 個 | 出力形式を示す |
フューショット | 2 個以上(通常 2〜5 個) | 独自ラベル、厳密な形式、エッジケース |
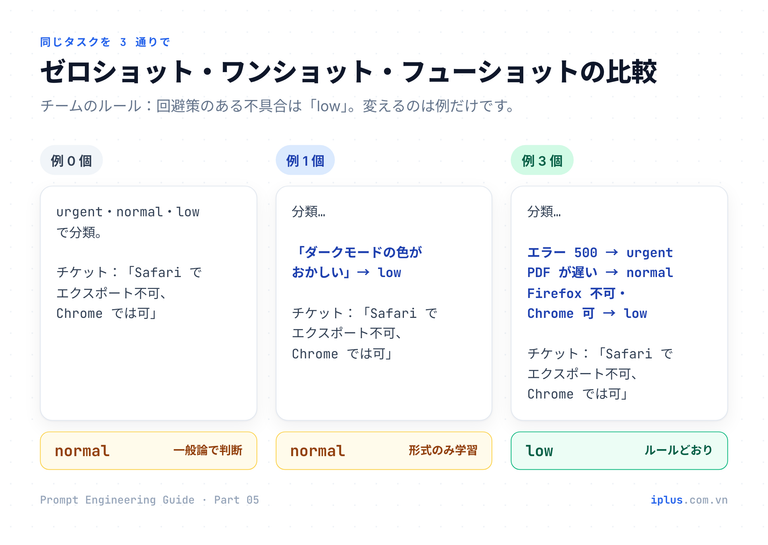
違いを見るために、同じサポートチケットを 3 通りの方法で分類します。チケットの内容は本物の不具合ですが、回避策があります。架空のチームのルールでは、回避策のある不具合は low です。
ゼロショット:指示のみ
このサポートチケットの優先度を urgent、normal、low のいずれかに分類してください。
ラベルのみを答えてください。

チケット:「Safari でエクスポートボタンを押しても何も起きません。Chrome からならエクスポートできます。」normal出力例:文言は実行ごと・モデルごとに変わります
答えとしては妥当ですが、チームのルールとは違います。モデルはチームのルールを知らないので、一般的な「優先度」の感覚で判断しています。
ワンショット:例を 1 つ
各サポートチケットの優先度を urgent、normal、low のいずれかに分類してください。
ラベルのみを答えてください。

チケット:「設定画面のダークモードの色が少しおかしいです。」
優先度:low

チケット:「Safari でエクスポートボタンを押しても何も起きません。Chrome からならエクスポートできます。」
優先度:normal出力例:文言は実行ごと・モデルごとに変わります
例が 1 つあることで形式(優先度:の後にラベルだけ)は揃いましたが、教えられたのは「見た目の問題は low」ということだけです。ボタンが動かないのは見た目の問題ではないので、答えは変わりません。
フューショット:ラベルごとに例を 1 つ
各サポートチケットの優先度を urgent、normal、low のいずれかに分類してください。
ラベルのみを答えてください。

<examples>
チケット:「誰もログインできません。ログイン画面がエラー 500 を返します。」
優先度:urgent

チケット:「PDF レポートの生成に 10 秒ではなく約 2 分かかります。」
優先度:normal

チケット:「Firefox で一括削除が失敗します。Chrome では動くので、当面はそちらを使っています。」
優先度:low
</examples>

チケット:「Safari でエクスポートボタンを押しても何も起きません。Chrome からならエクスポートできます。」
優先度:low出力例:文言は実行ごと・モデルごとに変わります
3 つ目の例が、誰も文章にしていなかったルールを運んでいます。「あるブラウザでは壊れているが、別のブラウザでは動く、だから low」。モデルは新しいチケットをこのパターンに当てはめました。
ポイント:チャット画面では、ブロック全体を 1 つのメッセージとして貼り付けてください。最後の行の 優先度: が回答の合図になり、返答がどこから始まるかをモデルに伝えます。ゼロショットとフューショットの使い分け
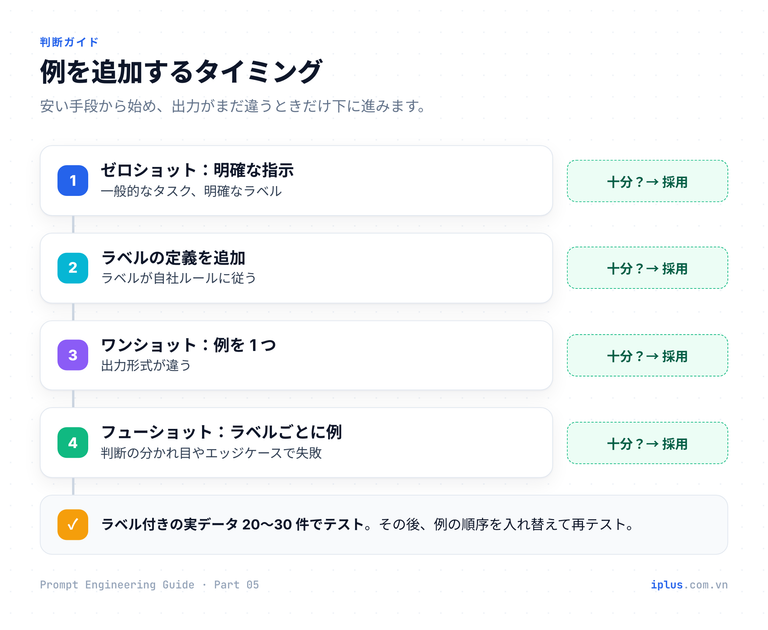
例は毎回のリクエストでトークンを消費し、保守の手間もかかるため、最初に試すべき手段ではありません。最近のモデルは指示によく従います。OpenAI の推論モデルのベストプラクティスも、推論モデルではまずゼロショットを試し、必要な場合にだけ例を追加するよう明記しています。多くの場合、各ラベルを定義するだけで差の大半が埋まります。
このサポートチケットの優先度を分類してください。

定義:
- urgent:多くのユーザーが作業できない、データ損失、セキュリティや請求の誤り、回避策なし
- normal:一部のユーザーで機能が壊れている・遅い、簡単な回避策なし
- low:見た目の問題、または回避策がある不具合

ラベルのみを答えてください。

チケット:「{ticket_text}」
{ticket_text} をチケットの本文に置き換えます。先ほどの Safari のチケットなら:
low出力例:文言は実行ごと・モデルごとに変わります
定義で改善しなくなったらフューショットに進みます。目安は、ラベルが言葉にしにくい判断に依存しているとき、出力形式が厳密なとき、同じエッジケースで間違い続けるときです。実務で最も強いのは両方の組み合わせです。定義で各ラベルの意味を伝え、例で境界線の位置を示します。
フューショットの例で出力形式を制御する
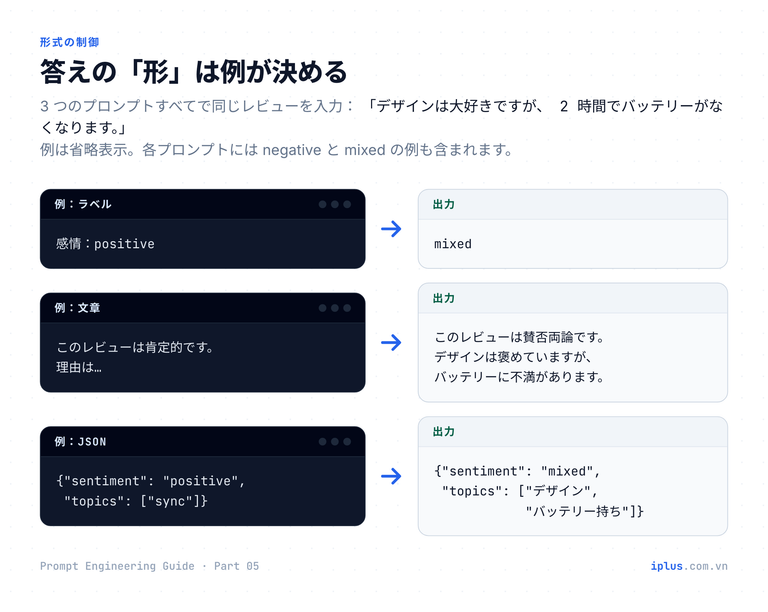
これが例の最も役立つ使い方です。モデルは、形式を文章で説明されるよりも、例の「形」をより安定して再現します。例を変えれば、同じ入力が単語 1 つにも、文章にも、JSON オブジェクトにもなります。以下はそのまま使える JSON 版です。
各アプリレビューを JSON に変換してください。例の形式に厳密に従ってください。

レビュー:「同期が速くて、新しいウィジェットも最高です。」
JSON:{"sentiment": "positive", "topics": ["同期", "ウィジェット"], "needs_reply": false}

レビュー:「アップデート後にメモが全部消えました。バックアップからの復元もできませんでした。」
JSON:{"sentiment": "negative", "topics": ["データ消失", "バックアップ"], "needs_reply": true}

レビュー:「デザインはすっきりしていて良いですが、大きなノートブックでは検索が遅いです。」
JSON:{"sentiment": "mixed", "topics": ["デザイン", "検索速度"], "needs_reply": false}

レビュー:「{review_text}」
JSON:
{review_text} を実際のレビューに置き換えます。「デザインは大好きですが、2 時間でバッテリーがなくなります。」なら、次のようになります。
{"sentiment": "mixed", "topics": ["デザイン", "バッテリー持ち"], "needs_reply": true}出力例:文言は実行ごと・モデルごとに変わります
mixed の例に注目してください。これがなければ、モデルはこのレビューを positive か negative に無理に押し込むか、独自のラベルを作るしかありません。例は形式だけでなく、許される答えの範囲も決めています。
例のパターン | モデルの出力 |
|---|---|
| レビューごとに 1 単語 |
| 理由付きの 1 文 |
| 同じキーを持つ JSON オブジェクト |
フューショットで雑多なテキストから情報を抽出する
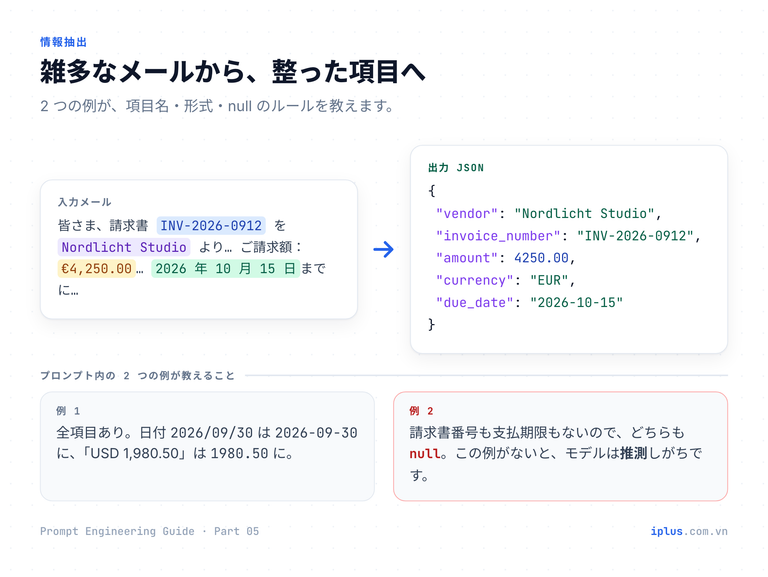
手作業を最も減らせるのが情報抽出です。取引先からのメール、履歴書、注文メモ、契約書を、スプレッドシートに貼れる行やコードで処理できるデータに変えられます。例は 4 つのことを同時に教えます。項目名、日付の形式、数値の形式、そして値がないときに何を書くかです。
各メールから請求書の情報を抽出してください。日付は ISO 形式(YYYY-MM-DD)、
数値は通貨記号なし、記載がない項目は null にしてください。

メール:「お世話になっております。8 月分クラウドホスティングの請求書 #A-7731 を添付します。
ご請求額:USD 1,980.50、お支払期限:2026/09/30。Harbor Cloud」
出力:{"vendor": "Harbor Cloud", "invoice_number": "A-7731", "amount": 1980.50, "currency": "USD", "due_date": "2026-09-30"}

メール:「7 月の撮影分のご請求です:12,000,000 VND。よろしくお願いします!Linh Studio」
出力:{"vendor": "Linh Studio", "invoice_number": null, "amount": 12000000, "currency": "VND", "due_date": null}

メール:「{email_text}」
出力:
{email_text} にメール本文を貼り付けます。例えば:
メール:「皆さま、9 月分デザイン顧問料の請求書 INV-2026-0912 を Nordlicht Studio より
お送りします。ご請求額:€4,250.00(税込)。2026 年 10 月 15 日までにお支払いください。Mara」

出力:{"vendor": "Nordlicht Studio", "invoice_number": "INV-2026-0912", "amount": 4250.00, "currency": "EUR", "due_date": "2026-10-15"}
出力例:文言は実行ごと・モデルごとに変わります
重要なのは 2 つ目の例です。請求書番号と支払期限がない場合に、推測ではなく null を返すことを示しています。こうした例がないと、モデルはもっともらしい値で空欄を埋めがちで、経理データでは最悪の結果になります。長い文書や表の扱いは 要約・表・文書分析のプロンプト を参照してください。
注意:抽出した数値は必ず原文と照合してください。モデルが数字を 1 桁写し間違えても、出力からはそれがわかりません。
使い回せるフューショット・プロンプトのテンプレート
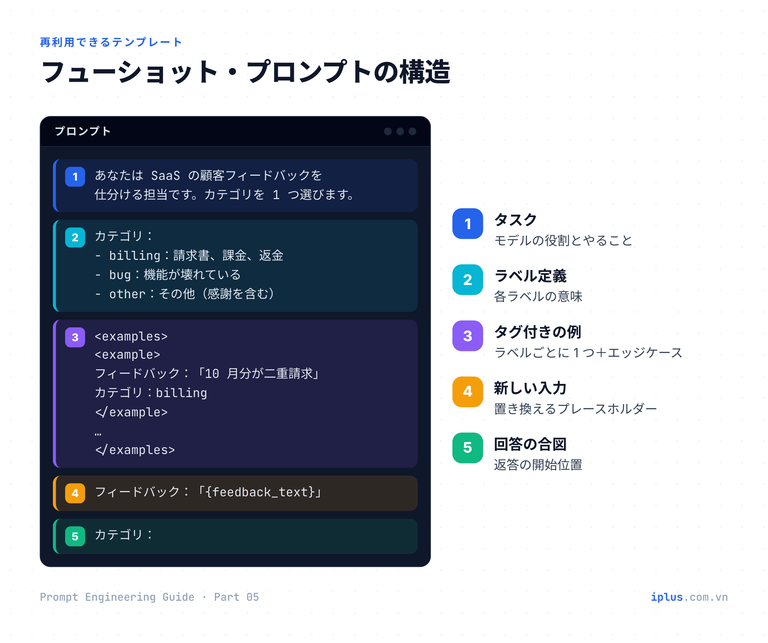
うまく動いたプロンプトは、使い回し、編集し、同僚に渡すことになります。決まったレイアウトにしておくと読みやすさが保てます。例をタグで囲むと、モデルが例と指示を区別しやすくなります。Anthropic のプロンプトガイドも同じ理由でこれを推奨しています。次のテンプレートは顧客フィードバックを分類するもので、モデルが間違えやすいエッジケースも含めています。
あなたはプロジェクト管理 SaaS の顧客フィードバックを仕分ける担当です。
カテゴリを 1 つだけ割り当ててください。

カテゴリ:
- billing:請求書、課金、返金、プラン変更
- bug:動いていた/動くべき機能が壊れている
- feature_request:製品にない機能の要望
- account:ログイン、パスワード、ユーザー枠、権限
- other:上記以外(要望のない感謝の言葉を含む)

<examples>
<example>
フィードバック:「10 月分が二重に請求されました。」
カテゴリ:billing
</example>
<example>
フィードバック:「サブタスクのガントチャート表示を追加してください。」
カテゴリ:feature_request
</example>
<example>
フィードバック:「昨日から、ボード間のドラッグ&ドロップができません。」
カテゴリ:bug
</example>
<example>
フィードバック:「今週のサポートチームの対応は素晴らしかったです。ありがとうございました!」
カテゴリ:other
</example>
</examples>

フィードバック:「{feedback_text}」
カテゴリ:
{feedback_text} を置き換えます。「5 人目のメンバーを追加できません。ユーザー枠の上限に達したと表示されます。」なら、モデルは次のように返します。
account出力例:文言は実行ごと・モデルごとに変わります
ユーザー枠の上限は billing と account の境界にあります。カテゴリの定義がこれを決着させ、感謝の言葉の例が、褒め言葉を製品のカテゴリに無理やり入れるのを防いでいます。
研究に基づくフューショット・プロンプティングのベストプラクティス
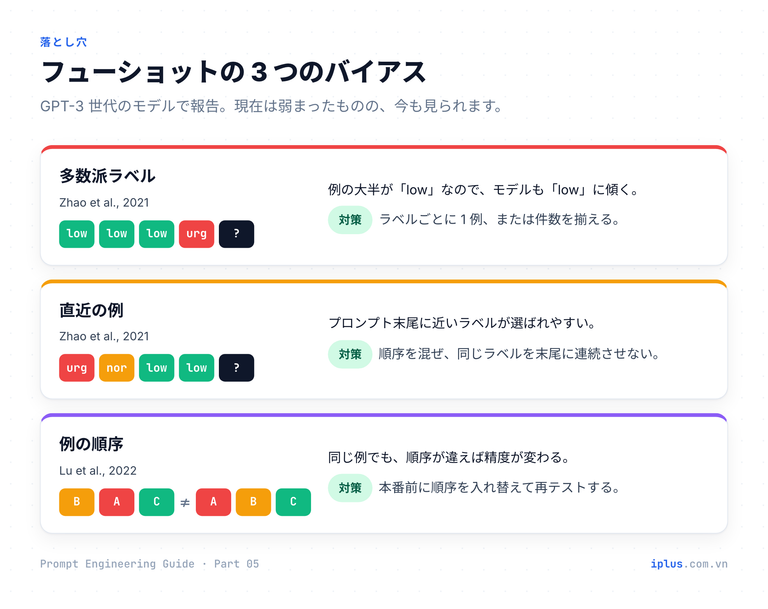
フューショット・プロンプティングは GPT-3 世代のモデルで盛んに研究され、その知見は今でも、実務で目にする失敗の大半を説明できます。実践上特に重要なのは次の 3 つです。
- 形式とラベルの範囲は、想像以上に重要。Min ら(2022 年)は、例のラベルをランダムに入れ替えても、12 のモデルで分類・多肢選択タスクの性能がほとんど落ちないことを示しました。結果を左右したのは、例が「取りうるラベル」「入力テキストの種類」「全体の形式」を示していたことです。その後の Wei ら(2023 年)の研究では、大きなモデルは例のラベルに従う(逆転させたラベルにさえ従う)ことが示されました。実務上のルールは、形式とラベルの集合を正しく作り、ラベル自体も正しくすることです。最近のモデルはラベルから学ぶからです。
- モデルは特定の答えに偏る。Zhao ら(2021 年)は、形式・例の選び方・順序によって、フューショットの精度がほぼ当てずっぽうの水準から当時の最高水準まで変動することを示しました。原因は、頻出するラベルやプロンプト末尾近くのラベルをモデルが好むことです。
- 順序で結果が変わる。Lu ら(2022 年)は、同じ例でも並べる順序によって、最高水準に近い性能とランダムな推測並みの性能の差が生じること、そしてあるモデルで良い順序が別のモデルでは通用しないことを示しました。
現在のモデルは GPT-3 よりはるかに頑健ですが、こうした効果の傾向は本番のプロンプトでも現れます。対策となる習慣は次の 6 つです。
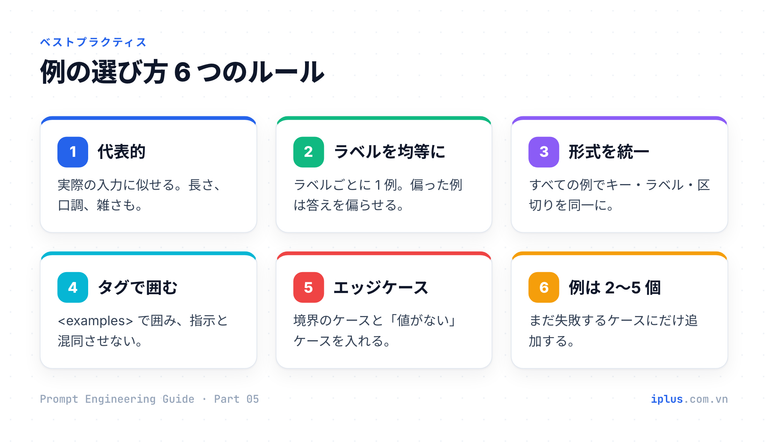
難しいのは例の選び方です。抜けている部分は、モデルに探させることができます。手持ちの例を次のプロンプトに貼り付けてください。
サポートチケットの分類に使っているフューショットの例は次のとおりです。

{your_examples}

これらの例ではうまくカバーできない、現実的なチケットを 5 つ挙げてください。
2 つのラベルの境界にあるケースや、珍しい言い回しのケースを選んでください。
それぞれに、適切だと思うラベルと、なぜ判断が難しいかを 1 行で添えてください。1.「請求書に先月のロゴが表示されています。」おそらく low:請求関連の書類だが、
見た目の問題。「請求書」という語が urgent に引っ張る可能性がある。
2.「40 人中 2 人がログインできません。」おそらく normal:ログインはできないが、
一部のユーザーのみ。urgent の例は「誰も」となっている。
3.「エクスポートはできるが、CSV の日付形式が違う。」おそらく normal:
出力が誤っているがエラー表示はなく、回避策も不明確。
(一部省略)出力例:文言は実行ごと・モデルごとに変わります
このうち現実的なものを 2〜3 個、チームが実際に望むラベルを付けて例に加えてください。フューショット・プロンプトはこうして時間とともに改善されていきます。
限界と、構造化出力を使うべき場面
本番で頼る前に、フューショット・プロンプティングのコストを知っておきましょう。
- 形式だけでなく内容まで真似る。すべての例が「請求書」に触れていると、モデルは請求書と無関係な入力にも請求書を見出すことがあります。例ごとにトピック、長さ、言い回しを変えてください。
- 表面的なパターンを学ぶ。urgent の例すべてに「エラー」という語が入っていると、モデルは「エラー=urgent」と学びかねません。この語を含まない urgent の例も入れましょう。
- トークンのコスト。例はリクエストのたびに送信されます。大量に処理する分類器で長い例を 10 個使えば、積み重なります。例は短くし、結果を変えない例は削ってください。
- 有効な JSON の保証はない。例があれば形式はほぼ守られますが、確実ではありません。
最後の点については、結果をコードでパースするなら API の構造化出力機能を使いましょう。たとえば OpenAI の Structured Outputs は、指定した JSON Schema に沿った応答を返させる機能です。前述の請求書抽出のスキーマは次のとおりです。
{
  "type": "object",
  "properties": {
    "vendor": { "type": "string" },
    "invoice_number": { "type": ["string", "null"] },
    "amount": { "type": "number" },
    "currency": { "type": "string", "description": "ISO 4217 コード(例:USD)" },
    "due_date": { "type": ["string", "null"], "description": "YYYY-MM-DD" }
  },
  "required": ["vendor", "invoice_number", "amount", "currency", "due_date"],
  "additionalProperties": false
}
スキーマは形を保証し、例は「2026/09/30」をどう読むか、いつ null を返すかといった判断を教えます。両方を組み合わせて使いましょう。例をロール・指示・背景情報と 1 つのプロンプトにまとめる方法は、技法の組み合わせ・プライミング・反復改善 と プロンプトの構造:5 つの構成要素 で解説しています。
よくある間違いとチェックリスト
間違い | 起きること | 対策 |
|---|---|---|
例がすべて同じラベル | そのラベルを出しすぎる | ラベルごとに 1 例、または件数を揃える |
例が似通っている | トピックや言い回しを真似る | トピック・長さ・表現を変える |
値がない場合を示していない | もっともらしい値を作る | null を返す例を加える |
例ごとに形式が違う | 出力形式がぶれる | ラベル・キー・区切りを統一 |
例が指示と矛盾している | 結果が予測できない | 指示と例を一致させる |
難しいケースを入れていない | 本番でエッジケースが失敗 | 実データの境界ケースを加える |
フューショット・プロンプトを本番に出す前に、ラベル付け済みの実データ 20〜30 件で試し、例の順序を入れ替えてもう一度試してください。結果が目に見えて変わるなら、例の見直しが必要です。
FAQ
フューショット・プロンプトに入れる例はいくつが適切ですか?
通常は 2〜5 個です。まずラベルごと、または形式のバリエーションごとに 1 つずつ用意し、まだ失敗するケースにだけ例を追加します。例を増やすと毎回のトークンが増え、パターンが明確になった後はほとんど効果がありません。
フューショットはゼロショットより優れていますか?
常にではありません。ラベルが明確な一般的タスクなら、明確なゼロショットの指示のほうが安く、多くの場合同じくらい良い結果になります。フューショットが勝るのは、ラベルが自社独自のルールに従うとき、形式が厳密でなければならないとき、特定のエッジケースで失敗が続くときです。
推論モデルにもフューショットの例は必要ですか?
必要な場面は減っています。OpenAI は推論モデルではまずゼロショットを試し、複雑な出力要件がある場合にだけ例を加えるよう勧めています。Anthropic は、例が Claude の思考における類似問題への取り組み方を方向付けると説明しています。形式を確実に固定する手段として、例は今も最も信頼できる方法です。
フューショット・プロンプティングとファインチューニングの違いは?
フューショット・プロンプティングはリクエストごとにプロンプトへ例を入れる方法で、モデル自体は何も変わりません。ファインチューニングは大量の例でモデルを学習させ、振る舞いを組み込む方法です。まずはフューショットを試しましょう。すぐに使え、変更も無料で、ほとんどの業務タスクには十分です。
参考資料
- Learn Prompting: Shot-Based Prompting(ゼロショット・ワンショット・フューショット)
- Brown ら(2020)Language Models are Few-Shot Learners
- Min ら(2022)Rethinking the Role of Demonstrations
- Zhao ら(2021)Calibrate Before Use
- Lu ら(2022)Fantastically Ordered Prompts and Where to Find Them
- Wei ら(2023)Larger language models do in-context learning differently
- Anthropic:Prompting best practices(例と XML タグ)
- OpenAI:Reasoning best practices
- OpenAI:Structured Outputs
Prompt Engineering ガイド 全記事
← 前の回:第4回:指示プロンプトとロールプロンプト · 次の回:第6回:技法の組み合わせ・プライミング・反復改善 →
第1〜6回は前の回を前提にしているため、順番にお読みください。第7〜10回は基礎を押さえた後なら、どの順番でも読めます。
この分野でお困りですか?
本記事に関連する iPlus Solution のサービスをご覧ください。