Hướng dẫn Prompt Engineering · Phần 9/10. Đây là phần ứng dụng: bạn cần nắm kiến thức cơ bản từ Phần 1–6. Mới theo dõi chuỗi bài? Hãy bắt đầu với Phần 1: Prompt engineering là gì và vì sao quan trọng.
Một AI coding assistant viết ra đoạn code trông hợp lý chỉ trong vài giây. Code đó có chạy được hay không phụ thuộc chủ yếu vào prompt: phiên bản ngôn ngữ nào, quy tắc nào, thông báo lỗi nào, và bạn sẽ kiểm tra kết quả ra sao. Hướng dẫn này đưa bạn các prompt cho AI coding assistant dùng ngay cho công việc hằng ngày: tạo, giải thích, debug, refactor, chuyển đổi, test và review code, mỗi prompt kèm một kết quả mẫu.
Mọi prompt đều chạy được trên ChatGPT, Claude, Gemini hoặc khung chat trong IDE của bạn. Các phần cuối bàn về coding agent và việc kiểm chứng. Các prompt tái sử dụng những khối nền tảng trong bài năm thành phần của một prompt, nên hãy đọc bài đó trước nếu các thuật ngữ còn mới.
Tạo code từ đặc tả, không phải từ một mong muốn
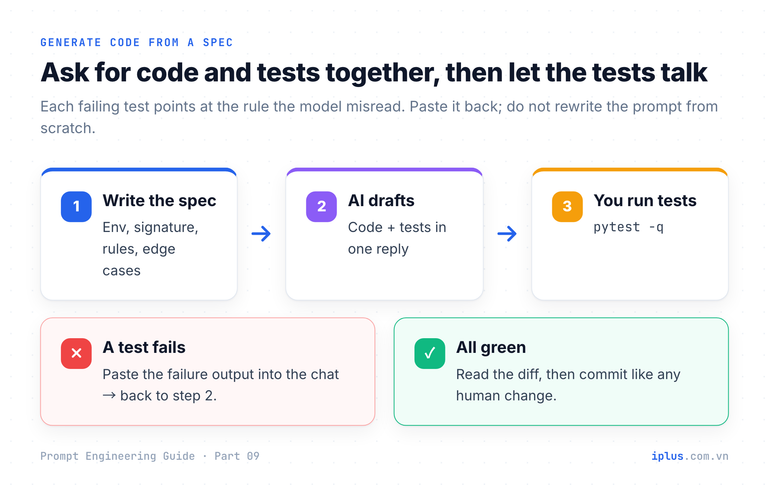
"Viết một hàm đếm ngày làm việc" để model tự đoán phiên bản, việc có tính cả hai đầu ngày hay không, cách xử lý ngày lễ và đầu vào sai thì làm gì. Mỗi lần đoán là một bug có thể xảy ra. Hãy viết prompt như một ticket nhỏ: môi trường, signature, quy tắc, edge case, và test ngay trong cùng câu trả lời để kiểm tra từng phỏng đoán.
Bạn là lập trình viên Python senior.

Môi trường: Python 3.12, chỉ dùng thư viện chuẩn.
Nhiệm vụ: viết một hàm với signature sau:
    business_days_between(start: date, end: date, holidays: Iterable[date] = ()) -> int

Quy tắc:
- Đếm từ thứ Hai đến thứ Sáu từ start đến end, tính cả hai đầu ngày.
- Bỏ qua mọi ngày có trong holidays. Ngày lễ rơi vào cuối tuần không làm thay đổi gì.
- Nếu start sau end, raise ValueError.

Edge case: cùng một ngày, khoảng chỉ gồm cuối tuần, ngày lễ rơi vào cuối tuần.
Đầu ra: 1) hàm có docstring và type hint,
2) test pytest bao phủ mọi quy tắc và edge case. Không giải thích thêm.# workdays.py
from collections.abc import Iterable
from datetime import date, timedelta
def business_days_between(
start: date, end: date, holidays: Iterable[date] = ()
) -> int:
"""Count weekdays (Mon-Fri) from start to end, inclusive, minus holidays."""
if start > end:
raise ValueError("start must be on or before end")
holiday_set = set(holidays)
count = 0
current = start
while current <= end:
if current.weekday() < 5 and current not in holiday_set:
count += 1
current += timedelta(days=1)
return count
# test_workdays.py
from datetime import date
import pytest
from workdays import business_days_between
def test_full_week_counts_five_days():
assert business_days_between(date(2026, 10, 19), date(2026, 10, 25)) == 5
def test_weekday_holiday_is_skipped():
culture_day = date(2026, 11, 3) # thứ Ba
assert business_days_between(date(2026, 11, 2), date(2026, 11, 8), [culture_day]) == 4
def test_start_after_end_raises():
with pytest.raises(ValueError):
business_days_between(date(2026, 10, 25), date(2026, 10, 19))
# (rút gọn: các test cùng ngày, chỉ cuối tuần và ngày lễ cuối tuần)Kết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Lưu hai tệp, chạy pytest và bạn sẽ thấy 6 passed. Nếu một test thất bại, hãy dán lỗi lại: nó cho thấy model đã hiểu sai quy tắc nào.
Phiên bản tái sử dụng. Thay mỗi {…} bằng thông tin của bạn:
Bạn là lập trình viên {language} senior.

Môi trường: {language + version}, {framework/thư viện được phép}.
Nhiệm vụ: {cần xây dựng gì}, với signature sau: {signature}

Quy tắc:
- {rule 1}
- {rule 2}

Edge case: {liệt kê}
Đầu ra: code, sau đó là test {test framework} bao phủ mọi quy tắc và edge case.
Mẹo: đặt các quy tắc trên những dòng riêng. Điều kiện bị chôn trong một câu dài sẽ bị bỏ qua.
Giải thích và chú thích code lạ
Hãy nêu người đọc ("một lập trình viên junior") để lời giải thích có đúng độ sâu, và tách "giải thích" khỏi "thay đổi": chú thích mà không sửa code thì dễ review.
Giải thích hàm TypeScript này cho một lập trình viên junior.
1. Nói trong một câu nó làm gì.
2. Đi qua từng dòng và gọi tên từng tính năng ngôn ngữ mà nó dùng.
3. Đưa một ví dụ sử dụng kèm kết quả.
4. Trả lại đúng đoạn code đó với chú thích TSDoc được thêm vào. Không thay đổi bất kỳ dòng code nào.

<code>
export const groupBy = <T, K extends PropertyKey>(items: T[], key: (item: T) => K) =>
  items.reduce((acc, item) => {
    (acc[key(item)] ||= []).push(item)
    return acc
  }, {} as Record<K, T[]>)
</code>Nó làm gì: gom một mảng thành một object với khóa do hàm key tạo ra,
ví dụ gom các support ticket theo trạng thái.
Từng dòng một:
- <T, K extends PropertyKey>: generics. K bị giới hạn ở các kiểu được phép
làm khóa object (string | number | symbol).
- items.reduce(..., {} as Record<K, T[]>): gộp từng phần tử vào một
object rỗng dạng "khóa -> danh sách phần tử".
- (acc[key(item)] ||= []): phép gán logical OR (ES2021). Tạo mảng của
nhóm nếu nó chưa tồn tại, rồi trả về mảng đó.
- .push(item); return acc: thêm phần tử và truyền object đi tiếp.
Ví dụ:
groupBy(tickets, (t) => t.status)
// {"open":[{"id":1,...},{"id":3,...}],"closed":[{"id":2,...}]}Kết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Debug với toàn bộ thông báo lỗi, không phải bản tóm tắt
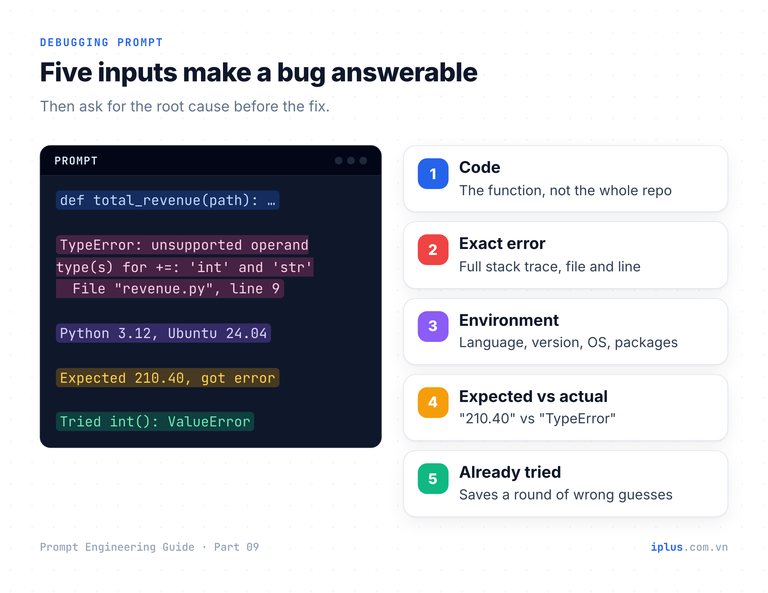
"Nó không chạy" buộc model phải đoán. Năm đầu vào giúp một prompt debug trả lời được: code, thông báo lỗi chính xác kèm stack trace, môi trường, hành vi mong đợi so với thực tế, và những gì bạn đã thử. Hãy yêu cầu nguyên nhân gốc trước khi sửa, để bạn đánh giá được lập luận chứ không chỉ bản patch.
Tìm nguyên nhân gốc của bug này trước khi đề xuất cách sửa.

Code (revenue.py):
import csv


def total_revenue(path):
    total = 0
    with open(path, newline="") as f:
        for row in csv.DictReader(f):
            if row["status"] == "paid":
                total += row["amount"]
    return total


print(total_revenue("orders.csv"))

Tệp đầu vào (orders.csv):
order_id,status,amount
1001,paid,120.50
1002,refunded,40.00
1003,paid,89.90

Lỗi:
Traceback (most recent call last):
  File "/app/revenue.py", line 13, in <module>
    print(total_revenue("orders.csv"))
  File "/app/revenue.py", line 9, in total_revenue
    total += row["amount"]
TypeError: unsupported operand type(s) for +=: 'int' and 'str'

Môi trường: Python 3.12 trên Ubuntu 24.04, không có package bên thứ ba.
Mong đợi: 210.40 (tổng các đơn đã thanh toán). Thực tế: lỗi ở trên.
Đã thử: bọc giá trị trong int(), nhưng nó raise ValueError với "120.50".

Trả lời gồm: 1) nguyên nhân gốc trong hai câu, 2) cách sửa tối thiểu,
3) mọi bug khác bạn thấy trong hàm này.1) Nguyên nhân gốc: csv.DictReader trả về mọi trường dưới dạng chuỗi, nên
row["amount"] là "120.50", không phải số. Python không thể cộng str vào
total kiểu int, do đó có TypeError; int() thất bại vì "120.50" không
phải là một số nguyên.
2) Cách sửa tối thiểu: parse amount thành Decimal, giữ chính xác phần xu.
from decimal import Decimal
...
total = Decimal("0")
...
total += Decimal(row["amount"])
Kết quả: 210.40 (float sẽ lệch với các đầu vào khác: 0.1 + 0.2 là
0.30000000000000004, sai đối với tiền)
3) Rủi ro khác: row["status"] == "paid" âm thầm bỏ qua "Paid " (hoa thường và
khoảng trắng). Hãy cân nhắc row["status"].strip().lower().Kết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Refactor, tối ưu và chuyển đổi code mà không đổi hành vi
Code AI "nhanh hơn" hay "gọn hơn" đôi khi chậm hơn, khác một cách tinh vi, hoặc cả hai. Hãy đưa ra ràng buộc cứng (cùng signature, cùng thứ tự đầu ra, không thêm dependency) và đòi bằng chứng bạn chạy được: một test tương đương với phiên bản cũ cùng một benchmark.
Tối ưu một hàm chậm, kèm bằng chứng
Tối ưu hàm Python 3.12 này. Nó mất khoảng một giây với 5,000 email
và chậm gấp bốn lần mỗi khi danh sách tăng gấp đôi.

def find_duplicate_emails(emails):
    duplicates = []
    for i, email in enumerate(emails):
        for other in emails[i + 1:]:
            if email.lower() == other.lower() and email.lower() not in duplicates:
                duplicates.append(email.lower())
    return duplicates

Ràng buộc:
- Cùng signature và đầu ra giống hệt, kể cả thứ tự.
- Chỉ dùng thư viện chuẩn.
Sau đó viết bench_dupes.py (1) assert rằng phiên bản cũ và mới trả về
cùng kết quả trên dữ liệu ngẫu nhiên và các edge case, và (2) đo thời gian cả hai.
Nêu độ phức tạp thời gian trước và sau.Độ phức tạp: bản gốc so sánh mọi cặp, O(n²) phép so sánh chuỗi,
cộng thêm tìm kiếm tuyến tính "not in duplicates" trong danh sách. Phiên bản dưới đây là O(n).
from collections import Counter
def find_duplicate_emails(emails: list[str]) -> list[str]:
"""Return lowercased emails that appear more than once, in first-seen order."""
counts = Counter(email.lower() for email in emails)
seen: set[str] = set()
result: list[str] = []
for email in emails:
key = email.lower()
if counts[key] > 1 and key not in seen:
seen.add(key)
result.append(key)
return result
# bench_dupes.py (rút gọn); bản gốc được giữ dưới tên find_duplicate_emails_old
emails = [f"user{random.randint(0, 3000)}@Example.com" for _ in range(5000)]
for case in (emails, [], ["[email protected]"], ["[email protected]", "[email protected]", "[email protected]", "[email protected]"]):
assert find_duplicate_emails(case) == find_duplicate_emails_old(case)
old = timeit.timeit(lambda: find_duplicate_emails_old(emails), number=1)
new = timeit.timeit(lambda: find_duplicate_emails(emails), number=1)
print(f"old: {old:.3f}s new: {new:.4f}s speed-up: {old / new:.0f}x")Kết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Trên máy của chúng tôi (Python 3.14, 5,000 email) script in ra old: 0.893s new: 0.0013s speed-up: 666x. Con số của bạn sẽ khác; điều quan trọng là các assert, vì chúng chứng minh kết quả giống nhau trước khi bạn tin vào tốc độ.
Chuyển đổi code giữa các ngôn ngữ
Bản dịch từng dòng thì biên dịch được, nhưng hành vi khác ở mọi chỗ hai ngôn ngữ bất đồng: làm tròn, chia số nguyên, kích thước số, ngày tháng. Hãy yêu cầu giữ nguyên hành vi, liệt kê các khác biệt ngữ nghĩa, và đưa test có đầu vào làm lộ chúng.
Chuyển đoạn JavaScript này sang Python 3.12. Giữ nguyên hành vi tuyệt đối,
kể cả làm tròn và xử lý số. Liệt kê mọi khác biệt ngữ nghĩa
giữa hai ngôn ngữ mà bạn đã phải xử lý, rồi đưa 3 test case
mà đầu vào của chúng sẽ làm lộ một bản chuyển đổi ngây thơ.

function lineTotal(unitPriceCents, qty, discountPct) {
  const gross = unitPriceCents * qty;
  const discount = Math.round((gross * discountPct) / 100);
  return gross - discount;
}import math
def js_round(x: float) -> int:
"""Match JavaScript Math.round: halves round up (toward +infinity)."""
return math.floor(x + 0.5)
def line_total(unit_price_cents: int, qty: int, discount_pct: float) -> int:
gross = unit_price_cents * qty
discount = js_round(gross * discount_pct / 100)
return gross - discount
Các khác biệt ngữ nghĩa đã xử lý:
1. Làm tròn: Math.round làm tròn một nửa lên (2.5 -> 3); round() của Python
làm tròn về số chẵn (2.5 -> 2), nên js_round() tái tạo lại hành vi của JS.
2. Kích thước số: số nguyên JS chỉ chính xác đến 2^53 - 1; int của Python
không giới hạn. Kết quả giống nhau với mức giá thực tế.
Test case (unit_price_cents, qty, discount_pct -> kết quả mong đợi):
- (125, 1, 2) -> 122 round() ngây thơ cho 123
- (1999, 3, 10) -> 5397
- (350, 1, 5) -> 332Kết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Chúng tôi đã chạy cả hai: JavaScript và bản Python đã chuyển đổi đều trả về 122 5397 332; một bản chuyển đổi ngây thơ dùng round() trả về 123 cho trường hợp đầu, tức lệch một xu trên mỗi dòng hóa đơn.
Bẫy | JavaScript | Python | Java |
|---|---|---|---|
Làm tròn một nửa |
|
|
|
Chia số nguyên |
|
|
|
Modulo số âm |
|
|
|
Số nguyên lớn | Chính xác chỉ đến 2^53 − 1 | int không giới hạn | long 64-bit bị tràn |
Số thứ tự tháng |
|
|
|
Cung cấp ngữ cảnh nhiều tệp để model định hướng được
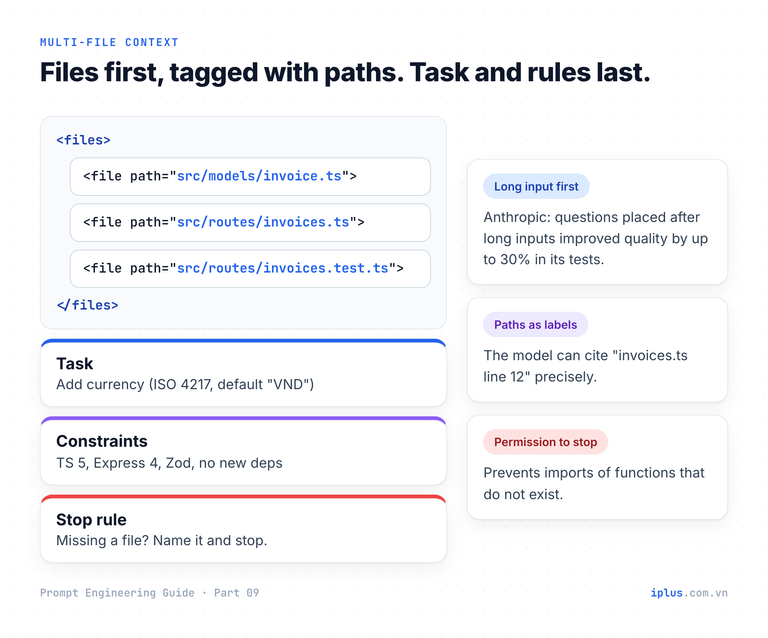
Chỉ dán những tệp liên quan, mỗi tệp gắn đường dẫn; tệp đặt trước, nhiệm vụ đặt sau. Anthropic cho biết câu hỏi đặt sau đầu vào dài có thể cải thiện chất lượng phản hồi tới 30%. Và hãy cho phép model dừng lại, điều này ngăn việc bịa import.
<files>
<file path="src/models/invoice.ts">
{paste file}
</file>
<file path="src/routes/invoices.ts">
{paste file}
</file>
<file path="src/routes/invoices.test.ts">
{paste file}
</file>
</files>

Nhiệm vụ: thêm trường currency tùy chọn (mã ISO 4217, mặc định "VND") vào
hóa đơn. Nhận nó trong POST /invoices, validate, và trả về trong response.
Ràng buộc: TypeScript 5, Express 4, Zod; không thêm dependency; các
test hiện có phải tiếp tục pass.
Trước khi viết code, liệt kê các tệp bạn sẽ thay đổi và lý do. Nếu bạn cần
một tệp tôi chưa đưa vào, hãy nêu tên nó và dừng lại.
Sau đó hiển thị từng thay đổi dưới dạng unified diff.
Thay mỗi {paste file} bằng nội dung tệp. Một phản hồi đầu tiên điển hình:
Kế hoạch
1. src/models/invoice.ts: thêm currency: string vào kiểu Invoice và
   đặt mặc định "VND" trong createInvoice().
2. src/routes/invoices.ts: mở rộng schema Zod với
   currency: z.string().regex(/^[A-Z]{3}$/).default("VND").
3. src/routes/invoices.test.ts: test rằng giá trị mặc định được áp dụng,
   "USD" được chấp nhận, còn "vnd" và "VNDX" trả về 400.

Thiếu ngữ cảnh: invoices.ts import saveInvoice từ src/db/invoices.ts,
nơi dựng câu INSERT, và bảng cần một migration. Vui lòng chia sẻ
src/db/invoices.ts và cấu trúc migration của bạn trước khi tôi viết các diff.
Kết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Unit test và code review bắt được bug thật
Tạo unit test
Hãy yêu cầu các hành vi trước, rồi mới đến test. Nêu tên framework và cấm mock hàm đang được test, một cách phổ biến khiến test do AI viết rốt cuộc chẳng kiểm tra gì. Chạy chúng, và cố tình làm hỏng hàm một lần để xác nhận test thất bại.
Viết test pytest cho hàm dưới đây.
Trước tiên liệt kê các hành vi và edge case bạn sẽ bao phủ, mỗi mục một dòng.
Sau đó viết test:
- dùng @pytest.mark.parametrize cho các nhóm trường hợp tương tự
- không mock chính mask_email
- gồm các đầu vào không hợp lệ phải raise ValueError

def mask_email(email: str) -> str:
    """Keep the first character of the local part, mask the rest: j***@example.com."""
    local, sep, domain = email.strip().partition("@")
    if not sep or not local or not domain or "@" in domain:
        raise ValueError(f"not an email address: {email!r}")
return f"{local[0]}{'*' * (len(local) - 1)}@{domain.lower()}"Hành vi: che mọi ký tự trừ ký tự đầu của phần local; giữ nguyên phần local
1 ký tự; chuyển domain về chữ thường; cắt khoảng trắng; từ chối địa chỉ sai định dạng.
# test_masking.py
import pytest
from masking import mask_email
@pytest.mark.parametrize(
("email", "expected"),
[
("[email protected]", "j*******@example.com"),
("[email protected]", "[email protected]"), # phần local một ký tự
("[email protected]", "J***@example.com"), # domain chuyển về chữ thường
# (rút gọn: trường hợp khoảng trắng)
],
)
def test_masks_valid_addresses(email, expected):
assert mask_email(email) == expected
@pytest.mark.parametrize(
"bad",
["", "no-at-sign", "@example.com", "john@", "a@[email protected]"],
)
def test_rejects_invalid_addresses(bad):
with pytest.raises(ValueError):
mask_email(bad)Kết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Tệp đầy đủ cho kết quả 9 passed.
Yêu cầu code review theo thang mức độ nghiêm trọng
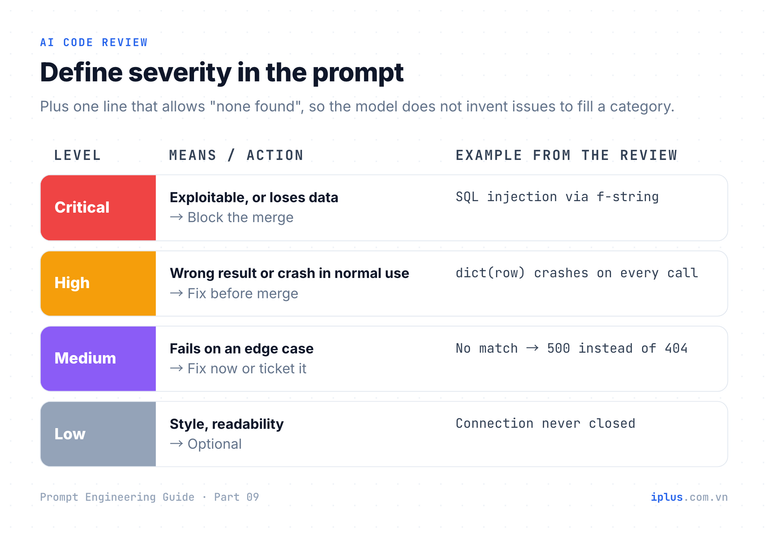
"Review đoạn code này" trộn lẫn chê bai về phong cách với lỗi thật. Hãy định nghĩa các nhóm và mức độ nghiêm trọng, yêu cầu mỗi phát hiện kèm dòng code và cách sửa, và cho phép trả lời "không thấy": nếu không, model có xu hướng bịa phát hiện để lấp đầy mọi nhóm.
Review endpoint Flask này (Python 3.12, SQLite) về bug, bảo mật,
hiệu năng và khả năng đọc.
Mức độ nghiêm trọng: Critical = có thể khai thác hoặc mất dữ liệu; High = kết quả sai hoặc
crash khi dùng bình thường; Medium = lỗi ở edge case; Low = phong cách.
Trả về một bảng: severity | line | problem | fix. Sắp xếp theo mức độ nghiêm trọng.
Nếu một nhóm không có vấn đề, ghi "none found" thay vì đoán.

@app.get("/users")
def find_user():
    email = request.args.get("email")
    conn = sqlite3.connect("app.db")
    row = conn.execute(f"SELECT * FROM users WHERE email = '{email}'").fetchone()
return jsonify(dict(row))| Severity | Line | Problem | Fix |
|----------|------|---------|-----|
| Critical | 5 | SQL injection: email được ghép thẳng vào câu truy vấn, nên ' OR '1'='1 trả về người dùng | Dùng tham số hóa: conn.execute("SELECT ... WHERE email = ?", (email,)) |
| High | 5-6 | SELECT * trả về mọi cột, kể cả password hash, cho client | Chỉ chọn các cột công khai (id, name, email) |
| High | 6 | dict(row) thất bại: row của sqlite3 là tuple trừ khi đặt row_factory | Đặt conn.row_factory = sqlite3.Row |
| Medium | 6 | Không có kết quả khớp trả về None, nên dict(None) raise và API trả 500 | Trả 404 khi row là None |
| Medium | 3 | Thiếu tham số email sẽ truy vấn với 'None' | Trả 400 khi không có email |
| Low | 4 | Connection không bao giờ được đóng | Dùng with closing(sqlite3.connect(...)) |
Performance: none found.Kết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Regex và lệnh shell một dòng: đòi test case
Lệnh một dòng rất cô đọng và dễ sai tinh vi, và các dialect khác nhau (regex Python so với JavaScript, công cụ GNU so với BSD). Hãy nêu rõ dialect và yêu cầu lời giải thích cùng các ví dụ khớp và không được khớp.
Viết một pattern Python (mô-đun re) kiểm tra ngày theo dạng YYYY-MM-DD.
- Giải thích từng phần của pattern.
- Đưa 4 chuỗi khớp và 4 chuỗi không được khớp.
- Nói pattern KHÔNG kiểm tra điều gì, và cách kiểm tra điều đó.Pattern (dùng với re.fullmatch):
[0-9]{4}-(0[1-9]|1[0-2])-(0[1-9]|[12][0-9]|3[01])
- [0-9]{4} năm bốn chữ số
- (0[1-9]|1[0-2]) tháng 01-12
- (0[1-9]|[12][0-9]|3[01]) ngày 01-31
Khớp: 2026-10-20, 1999-01-01, 2024-02-29, 2026-12-31
Không khớp: 2026-13-01, 2026-00-10, 2026-1-5, 2026-10-32
Không kiểm tra:
- Số ngày trong tháng: 2026-02-30 vẫn qua. Hãy dùng date.fromisoformat() cho việc đó.
- Tôi dùng [0-9], không dùng \d: trong Python, \d cũng khớp chữ số không phải ASCII
như 2026 toàn chiều rộng.
- Hãy dùng re.fullmatch thay vì ^...$ với re.match: $ cũng khớp
trước một ký tự xuống dòng ở cuối, nên "2026-10-20\n" sẽ qua.Kết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Chúng tôi đã kiểm tra từng nhận định bằng Python (xem tài liệu mô-đun re). Những chi tiết như vậy chỉ xuất hiện khi bạn hỏi "nó không kiểm tra điều gì?".
Cho tôi một lệnh shell liệt kê các tệp .log dưới /var/log lớn hơn
100 MB và được sửa đổi trong 7 ngày gần nhất, kèm kích thước. Lệnh phải chạy được trên
cả find của GNU (Linux) lẫn BSD (macOS). Không xóa gì cả.
Giải thích từng flag.find /var/log -type f -name '*.log' -size +100M -mtime -7 -exec ls -lh {} +
-type f chỉ tệp thông thường
-name '*.log' đặt trong dấu nháy để shell không mở rộng dấu *
-size +100M lớn hơn 100 MiB (chạy trên find của GNU và BSD)
-mtime -7 được sửa đổi cách đây chưa đến 7 ngày
-exec ls -lh {} + in kích thước, gom nhiều tệp vào một lần gọi lsKết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Prompt cho coding agent: tệp chỉ dẫn và task brief
Các coding agent (Claude Code, Cursor, GitHub Copilot, OpenAI Codex) chỉnh sửa tệp và chạy lệnh. Có hai loại prompt dẫn dắt chúng. Loại đầu là tệp chỉ dẫn được đọc ở đầu mỗi phiên: CLAUDE.md cho Claude Code, .github/copilot-instructions.md cho Copilot, .cursor/rules cho Cursor, và AGENTS.md, một định dạng mở được Codex, Cursor và Copilot đọc (Claude Code có thể đọc nó thay cho CLAUDE.md). Hãy giữ ngắn gọn: lệnh, quy ước, ranh giới an toàn.
# AGENTS.md

## Lệnh
- Type-check: `pnpm typecheck` (phải pass với không lỗi nào)
- Lint: `pnpm lint` (không có cảnh báo)
- Test: `pnpm vitest run`

## Quy ước
- TypeScript strict mode. Không dùng `any` trong code mới.
- API handler nằm trong `src/app/api/`; validate mọi request body bằng Zod.
- Tiền được lưu dưới dạng số nguyên theo đơn vị nhỏ nhất (cent/đồng), không bao giờ dùng float.

## Ranh giới an toàn
- Không bao giờ sửa tay các tệp trong `src/migrations/`; hãy tạo chúng bằng lệnh.
- Không bao giờ commit secret. Đọc cấu hình từ biến môi trường.
- Hỏi trước khi thêm dependency.
Loại thứ hai là task brief: mục tiêu, ràng buộc, định nghĩa "xong" mà agent có thể tự kiểm tra bằng cách chạy lệnh, và khi nào nên dừng lại để hỏi.
Mục tiêu: thêm rate limiting cho POST /api/contact: tối đa 5 request mỗi IP
mỗi 10 phút; request thứ 6 trả về 429 với { success: false, error }.

Ngữ cảnh: chúng tôi đã dùng Upstash Redis (xem src/lib/rate-limit.ts).
Ràng buộc: tái sử dụng helper đó; không thêm dependency; không đổi
cấu trúc response của các request thành công.
Xong khi: pnpm typecheck, pnpm lint và pnpm vitest run đều pass, và một
test mới chứng minh request thứ 6 trong khung thời gian nhận 429.
Dừng lại và hỏi nếu: helper không diễn đạt được khung 10 phút, hoặc
cần thay đổi ngoài src/app/api/contact/.Xong.
- route.ts: rateLimit(ip, { limit: 5, window: "10 m" }) đặt trước
bước validate; trả 429 với { success: false, error } khi vượt giới hạn.
- route.test.ts: 6 request từ một IP -> [200 x5, 429].
Kiểm tra: typecheck 0 lỗi, lint 0 cảnh báo, vitest 48 passed (1 mới).Kết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Một kỹ sư đặc tả và review trong khi agent triển khai chính là mô hình đằng sau phương pháp triển khai Claude Code × kỹ sư senior của chúng tôi.
Kiểm chứng mọi thứ: những điều AI hỗ trợ lập trình không làm được
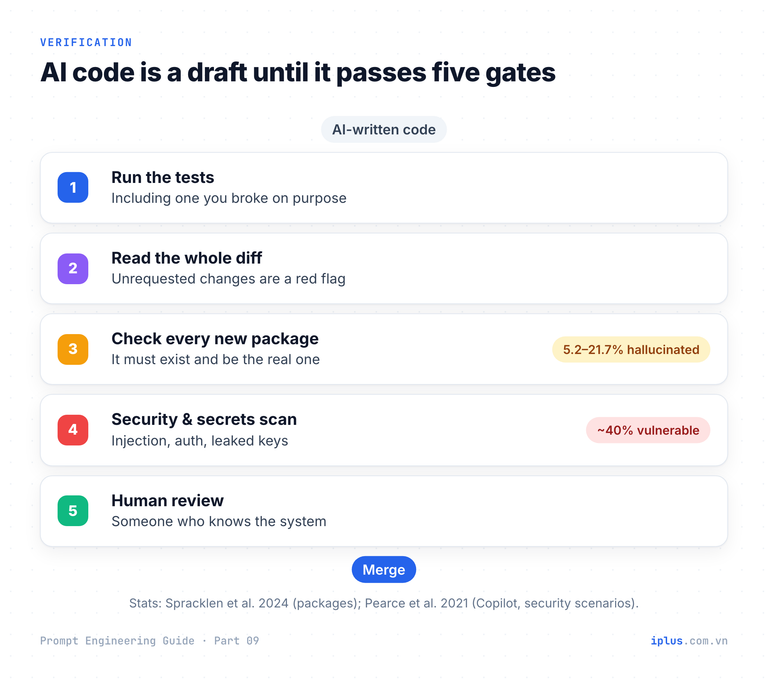
Trong một cuộc chat thông thường, model không chạy code của bạn trừ khi sản phẩm cung cấp công cụ thực thi. Kết quả của kiểu "hãy đóng vai terminal Linux" là bịa ra: một phỏng đoán, không bao giờ là kết quả test. Nghiên cứu cho thấy vì sao kiểm chứng không phải là tùy chọn:
- Pearce và cộng sự (2021) tạo 1,689 chương trình bằng GitHub Copilot trong các kịch bản liên quan đến bảo mật và thấy khoảng 40% có lỗ hổng.
- Spracklen và cộng sự (2024) phân tích 576,000 mẫu code: 5.2% package do các model thương mại gợi ý và 21.7% do model mã nguồn mở gợi ý không tồn tại, là những cái tên kẻ tấn công có thể đăng ký kèm mã độc.
- Trong một thử nghiệm ngẫu nhiên có đối chứng của METR năm 2025, các lập trình viên mã nguồn mở có kinh nghiệm chậm hơn 19% khi dùng công cụ AI nhưng lại tin rằng mình nhanh hơn 20%.
Các model đã tiến bộ kể từ đó, nhưng thời gian tiết kiệm được khi viết code phải được dùng để kiểm tra nó. Trước khi chạy bất cứ thứ gì, hãy hỏi model về các điểm yếu của nó:
Trước khi tôi chạy đoạn code này, hãy liệt kê:
1. mọi giả định bạn đã đặt ra về đầu vào, môi trường và phiên bản;
2. mọi package, hàm hay API bạn đã dùng mà tôi cần kiểm tra là có tồn tại
   trong {language/framework + version};
3. ba đầu vào dễ làm nó hỏng nhất.1. Giả định: CSV UTF-8 có dòng tiêu đề; "." là dấu phân cách thập phân.
2. Cần kiểm tra: csv.DictReader, decimal.Decimal (stdlib, Python 3.12).
3. Dễ hỏng: "1,200.50", "Paid " có dấu cách, amount để trống.Kết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Cảnh báo: không bao giờ dán secret, thông tin xác thực hay dữ liệu khách hàng vào công cụ AI. Hãy dùng placeholder như {API_KEY} và tuân theo chính sách công ty về chia sẻ mã nguồn.
Lỗi thường gặp với prompt lập trình AI
Lỗi | Điều gì xảy ra | Nên làm thay vào đó |
|---|---|---|
Không nêu ngôn ngữ hay phiên bản | Code cho sai runtime hoặc dùng API đã bị gỡ | Nêu rõ "Python 3.12", "Node 22", "Spring Boot 3" |
"Nó không chạy" | Model đoán một nguyên nhân | Dán lỗi chính xác, đầu vào, mong đợi so với thực tế |
Chấp nhận code "đã tối ưu" | Chậm hơn hoặc hành vi khác một cách tinh vi | Yêu cầu test tương đương và benchmark |
Dán cả repository | Các dòng liên quan bị loãng đi | Chỉ dán các tệp liên quan, gắn đường dẫn |
Tin vào kết quả giả lập | Kết quả "terminal" hay "SQL" là bịa ra | Tự chạy code hoặc dùng công cụ thực thi thật |
Cài package được gợi ý mà không kiểm tra | Package có thể không tồn tại hoặc độc hại | Kiểm tra trang trên registry, người bảo trì và lượt tải trước |
Dán secret hoặc dữ liệu khách hàng | Rò rỉ cho bên thứ ba | Dùng placeholder và tuân theo chính sách công ty |
FAQ
Prompt nào tốt nhất cho một AI coding assistant?
Không có prompt duy nhất; những prompt hiệu quả có chung cấu trúc: môi trường, nhiệm vụ kèm signature, quy tắc dạng danh sách, edge case, và test trong đầu ra. Mẫu đặc tả ở trên đáp ứng được hầu hết trường hợp.
AI có tìm được bug trong code của tôi không?
Thường là có, nếu được cung cấp lỗi chính xác, đầu vào và kết quả mong đợi. Nó yếu hơn với bug phụ thuộc trạng thái runtime mà nó không nhìn thấy, như nội dung cơ sở dữ liệu hay thời điểm xử lý. Hãy xác nhận nguyên nhân gốc của nó bằng một test.
Dán code của công ty vào ChatGPT hoặc Claude có an toàn không?
Tùy chính sách công ty và gói bạn dùng: gói business và API thường có điều khoản lưu trữ và huấn luyện khác với gói miễn phí. Không bao giờ dán secret hay dữ liệu cá nhân.
Reasoning model có còn cần "suy nghĩ từng bước" khi debug không?
Ít: dù sao chúng cũng suy luận trước khi trả lời. Yêu cầu nguyên nhân gốc trước khi sửa vẫn có ích, vì nó làm cho lập luận kiểm tra được. Xem kết hợp kỹ thuật để biết cách cấu trúc prompt nhiều bước.
Nguồn và tài liệu đọc thêm
- Learn Prompting: Coding Assistance
- Pearce et al. (2021): Asleep at the Keyboard?
- Spracklen et al. (2024): package hallucinations by code-generating LLMs
- METR (2025): AI and experienced open-source developer productivity
- Anthropic: Prompting best practices (long context prompting)
- Claude Code docs: How Claude remembers your project (CLAUDE.md, AGENTS.md)
- AGENTS.md: an open format for guiding coding agents
- GitHub Docs: Adding repository custom instructions for GitHub Copilot
- Cursor Docs: Rules
- Python docs: round() và MDN: Math.round()
Hướng dẫn Prompt Engineering: tất cả các phần
← Trước: Phần 8: Prompt cho email, bài blog và marketing · Tiếp: Phần 10: Xây dựng chatbot cơ sở tri thức (RAG) →
Hãy đọc Phần 1–6 theo thứ tự: mỗi phần xây trên phần trước. Phần 7–10 là phần ứng dụng và có thể đọc theo thứ tự bất kỳ khi bạn đã nắm kiến thức nền.
- Phần 1: Prompt engineering là gì và vì sao quan trọng
- Phần 2: LLM hoạt động thế nào: kiến thức nền về generative AI
- Phần 3: Cấu trúc prompt: năm thành phần của một prompt
- Phần 4: Instruction prompting và role prompting
- Phần 5: Zero-shot, one-shot và few-shot prompting
- Phần 6: Kết hợp kỹ thuật, priming và vòng lặp cải tiến
- Phần 7: Prompt cho tóm tắt, bảng biểu và phân tích tài liệu
- Phần 8: Prompt cho email, bài blog và marketing
- Phần 9: Prompt cho trợ lý lập trình (bạn đang ở đây)
- Phần 10: Xây dựng chatbot cơ sở tri thức (RAG)
Cần hỗ trợ về chủ đề này?
Các dịch vụ của iPlus liên quan nhất đến bài viết.