Hướng dẫn Prompt Engineering · Phần 5/10. Phần này tiếp nối Phần 4: Instruction prompting và role prompting. Bạn mới theo dõi loạt bài? Hãy bắt đầu từ Phần 1: Prompt engineering là gì và vì sao quan trọng.
Đôi khi chỉ một instruction là chưa đủ. Bạn nhờ mô hình gắn nhãn mức ưu tiên cho các phiếu hỗ trợ, và nó gắn một lỗi vặt là "normal" trong khi đội của bạn sẽ gọi đó là "low". Bạn yêu cầu JSON và nhận về JSON với các key khác nhau mỗi lần. Few-shot prompting giải quyết nhóm vấn đề này: thay vì mô tả điều bạn muốn, bạn cho mô hình xem vài ví dụ đã hoàn chỉnh và để nó sao chép theo khuôn mẫu.
Bài này trình bày zero-shot, one-shot và few-shot prompting qua một ví dụ xuyên suốt, rồi áp dụng kỹ thuật vào ba việc mang lại nhiều giá trị nhất: kiểm soát định dạng đầu ra, trích xuất trường dữ liệu từ văn bản lộn xộn và phân loại theo quy tắc riêng của bạn. Mỗi phần có một prompt bạn có thể dán vào ChatGPT, Claude hoặc Gemini, cùng kết quả bạn nên nhận được.
Zero-shot, one-shot và few-shot prompting nghĩa là gì
Các mô hình ngôn ngữ lớn có thể học một nhiệm vụ từ các ví dụ đặt ngay trong prompt, không cần huấn luyện lại. Cách này gọi là in-context learning (học trong ngữ cảnh). Đó là phát hiện nổi bật nhất của bài báo GPT-3, "Language Models are Few-Shot Learners" (Brown và cộng sự, 2020). Một ví dụ được gọi là một "shot", nên các tên gọi chỉ đơn giản là đếm số ví dụ:
Kỹ thuật | Số ví dụ trong prompt | Phù hợp nhất với |
|---|---|---|
Zero-shot | 0, chỉ có instruction | Các nhiệm vụ phổ biến có nhãn hiển nhiên |
One-shot | 1 | Minh họa một định dạng đầu ra |
Few-shot | 2 trở lên, thường là 2–5 | Nhãn riêng của bạn, định dạng nghiêm ngặt, các trường hợp biên |
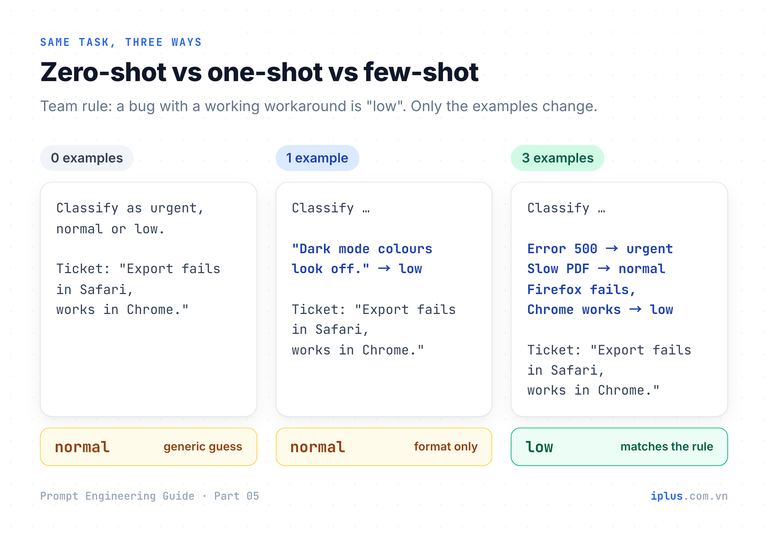
Để thấy sự khác biệt, chúng ta sẽ phân loại cùng một phiếu hỗ trợ ba lần. Phiếu này mô tả một lỗi có thật, nhưng đã có cách xử lý tạm. Trong chính sách giả định của đội chúng ta, một lỗi có cách xử lý tạm hiệu quả thì có mức ưu tiên low.
Zero-shot: chỉ có instruction
Phân loại mức ưu tiên của phiếu hỗ trợ này là urgent, normal hoặc low.
Chỉ trả lời bằng nhãn.

Ticket: "Nút xuất không làm gì cả trên Safari. Xuất từ Chrome thì được."normalKết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Câu trả lời hợp lý, chỉ là không đúng chính sách của bạn. Mô hình chưa từng thấy quy tắc của đội bạn, nên nó quay về cách hiểu chung chung về mức ưu tiên.
One-shot: một ví dụ
Phân loại mức ưu tiên của từng phiếu hỗ trợ là urgent, normal hoặc low.
Chỉ trả lời bằng nhãn.

Ticket: "Màu của chế độ tối trên trang cài đặt trông hơi lệch."
Priority: low

Ticket: "Nút xuất không làm gì cả trên Safari. Xuất từ Chrome thì được."
Priority:normalKết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Một ví dụ đã cố định được định dạng (một nhãn trơn sau Priority:), nhưng chỉ dạy được rằng lỗi hiển thị là low. Nút hỏng không phải lỗi hiển thị, nên câu trả lời vẫn như cũ.
Few-shot: một ví dụ cho mỗi nhãn
Phân loại mức ưu tiên của từng phiếu hỗ trợ là urgent, normal hoặc low.
Chỉ trả lời bằng nhãn.

<examples>
Ticket: "Không ai đăng nhập được. Trang đăng nhập trả về lỗi 500."
Priority: urgent

Ticket: "Báo cáo PDF mất khoảng hai phút để tạo thay vì mười giây."
Priority: normal

Ticket: "Xóa hàng loạt bị lỗi trên Firefox. Trên Chrome vẫn dùng được nên hiện tại chúng tôi dùng Chrome."
Priority: low
</examples>

Ticket: "Nút xuất không làm gì cả trên Safari. Xuất từ Chrome thì được."
Priority:lowKết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Ví dụ thứ ba mang quy tắc mà không ai viết ra: hỏng trên một trình duyệt, chạy được trên trình duyệt khác, nên là low. Mô hình đã khớp phiếu mới với khuôn mẫu đó.
Mẹo: trong cửa sổ chat, hãy dán toàn bộ khối này thành một tin nhắn. Dòng cuối Priority: đóng vai trò gợi ý câu trả lời, cho mô hình biết chính xác phần trả lời bắt đầu từ đâu.Khi nào dùng zero-shot, khi nào dùng few-shot
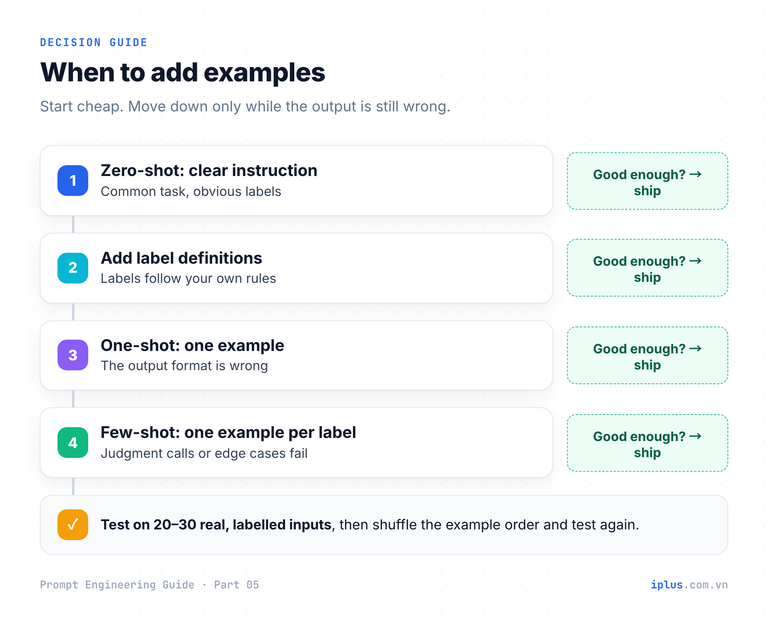
Ví dụ tốn token ở mỗi lần gọi và cần công sức duy trì, nên chúng không phải cách sửa đầu tiên cần nghĩ đến. Các mô hình hiện đại làm theo instruction khá tốt, và hướng dẫn reasoning của OpenAI khuyến nghị rõ ràng nên thử zero-shot trước với các reasoning model và chỉ thêm ví dụ khi đầu ra cần. Một định nghĩa rõ ràng cho từng nhãn thường đã thu hẹp phần lớn khoảng cách:
Phân loại mức ưu tiên của phiếu hỗ trợ này.

Định nghĩa:
- urgent: nhiều người dùng bị chặn, mất dữ liệu, lỗi bảo mật hoặc thanh toán, không có cách xử lý tạm
- normal: một tính năng bị hỏng hoặc chậm với một số người dùng, không có cách xử lý tạm dễ dàng
- low: lỗi hiển thị, hoặc lỗi có cách xử lý tạm hiệu quả

Chỉ trả lời bằng nhãn.

Ticket: "{ticket_text}"
Hãy thay {ticket_text} bằng nội dung phiếu. Với phiếu Safari ở trên:
lowKết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Chuyển sang few-shot khi các định nghĩa không còn giúp được nữa: nhãn phụ thuộc vào phán đoán khó diễn đạt thành lời, định dạng đầu ra nghiêm ngặt, hoặc cùng những trường hợp biên cứ liên tục ra sai. Trong thực tế, các prompt mạnh nhất kết hợp cả hai: định nghĩa nói mỗi nhãn nghĩa là gì, ví dụ cho thấy ranh giới nằm ở đâu.
Kiểm soát định dạng đầu ra bằng ví dụ few-shot
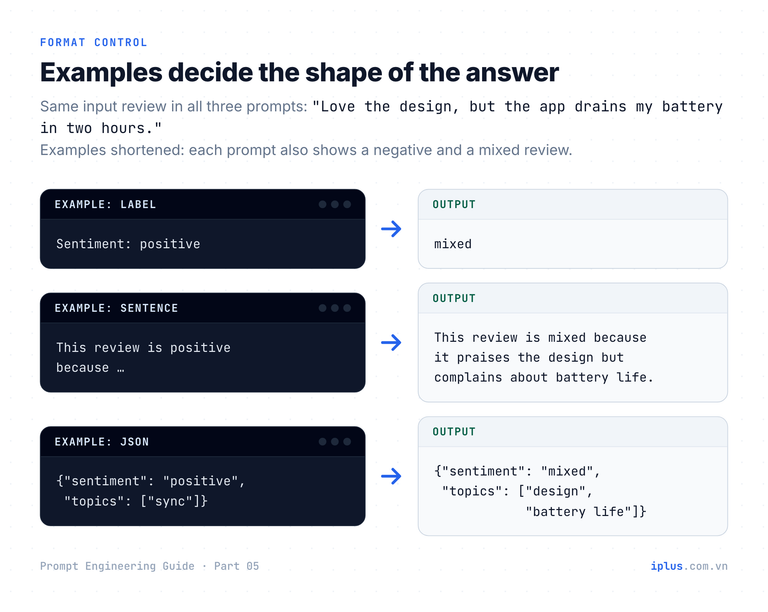
Đây là điều hữu ích nhất mà ví dụ làm được. Mô hình tái tạo hình dạng của các ví dụ nhất quán hơn là làm theo một mô tả bằng văn bản về hình dạng đó. Đổi các ví dụ và cùng một đầu vào có thể trả về một từ, một câu hay một đối tượng JSON. Dưới đây là phiên bản JSON, sẵn sàng để dùng:
Chuyển từng đánh giá ứng dụng thành JSON. Làm đúng theo các ví dụ.

Review: "Đồng bộ nhanh và các widget mới rất tuyệt."
JSON: {"sentiment": "positive", "topics": ["đồng bộ", "widget"], "needs_reply": false}

Review: "Mất hết ghi chú sau khi cập nhật. Khôi phục từ bản sao lưu cũng không được."
JSON: {"sentiment": "negative", "topics": ["mất dữ liệu", "sao lưu"], "needs_reply": true}

Review: "Thiết kế gọn đẹp, nhưng tìm kiếm chậm với các sổ ghi chú lớn."
JSON: {"sentiment": "mixed", "topics": ["thiết kế", "tốc độ tìm kiếm"], "needs_reply": false}

Review: "{review_text}"
JSON:
Hãy thay {review_text} bằng một đánh giá thật. Với “Thiết kế đẹp, nhưng ứng dụng ngốn hết pin sau hai giờ.” bạn nhận được:
{"sentiment": "mixed", "topics": ["thiết kế", "thời lượng pin"], "needs_reply": true}Kết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Hãy chú ý ví dụ mixed. Nếu không có nó, mô hình sẽ phải nhét đánh giá này vào positive hoặc negative, hoặc tự tạo một nhãn riêng. Ví dụ định nghĩa các câu trả lời được phép cũng nhiều như định dạng.
Mẫu ví dụ | Mô hình trả về |
|---|---|
| Một từ cho mỗi đánh giá |
| Một câu kèm lý do |
| Một đối tượng JSON với các key giống nhau |
Trích xuất trường dữ liệu từ văn bản lộn xộn bằng few-shot prompting
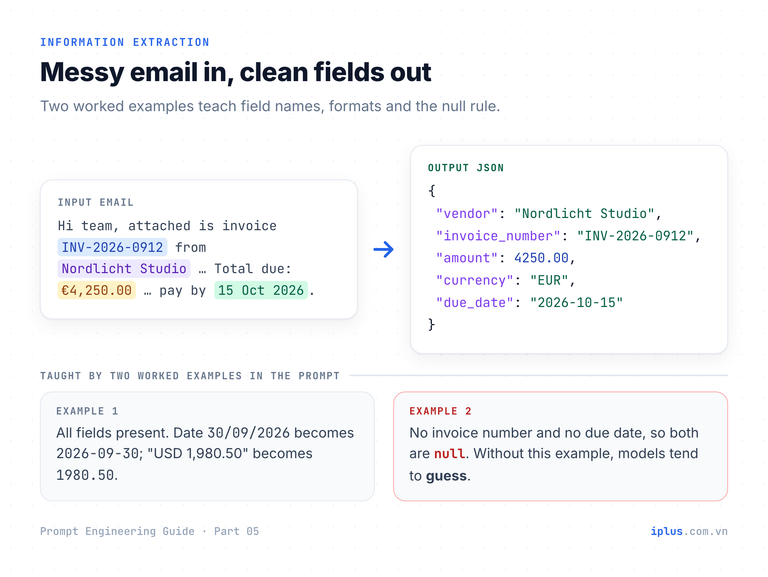
Trích xuất là nơi few-shot prompting tiết kiệm nhiều công sức thủ công nhất: email nhà cung cấp, CV, ghi chú đơn hàng hay hợp đồng trở thành các dòng dữ liệu bạn có thể dán vào bảng tính hoặc parse bằng code. Các ví dụ dạy cùng lúc bốn điều: tên trường, định dạng ngày, định dạng số và nội dung cần ghi khi thiếu giá trị.
Trích xuất thông tin hóa đơn từ từng email. Dùng ngày theo chuẩn ISO (YYYY-MM-DD),
số không kèm ký hiệu tiền tệ, và null cho bất cứ thông tin nào không được nêu.

Email: "Xin chào, đính kèm hóa đơn #A-7731 cho dịch vụ cloud hosting tháng 8.
Số tiền cần thanh toán: USD 1,980.50, hạn thanh toán 30/09/2026. Trân trọng, Harbor Cloud"
Output: {"vendor": "Harbor Cloud", "invoice_number": "A-7731", "amount": 1980.50, "currency": "USD", "due_date": "2026-09-30"}

Email: "Chào bạn, đây là phiếu thanh toán cho buổi chụp ảnh tháng 7: 12,000,000 VND.
Cảm ơn! Linh Studio"
Output: {"vendor": "Linh Studio", "invoice_number": null, "amount": 12000000, "currency": "VND", "due_date": null}

Email: "{email_text}"
Output:
Hãy dán email vào vị trí {email_text}. Ví dụ:
Email: "Chào cả nhóm, đính kèm là hóa đơn INV-2026-0912 của Nordlicht Studio cho
gói thiết kế tháng 9. Tổng cần thanh toán: €4,250.00 (đã gồm VAT). Vui lòng thanh toán
trước ngày 15/10/2026. Cảm ơn, Mara"

Output: {"vendor": "Nordlicht Studio", "invoice_number": "INV-2026-0912", "amount": 4250.00, "currency": "EUR", "due_date": "2026-10-15"}
Kết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Ví dụ thứ hai là ví dụ quan trọng. Nó cho thấy số hóa đơn và hạn thanh toán bị thiếu được trả về là null thay vì bị đoán. Nếu không có ví dụ như vậy, mô hình có xu hướng lấp chỗ trống bằng những giá trị nghe hợp lý, đây là kết quả tệ nhất với dữ liệu tài chính. Với tài liệu dài và bảng biểu, xem Prompt cho tóm tắt, bảng biểu và phân tích tài liệu.
Cảnh báo: luôn kiểm tra ngẫu nhiên các con số đã trích xuất so với nguồn. Mô hình có thể chép sai một chữ số, và không có gì trong đầu ra cho bạn biết điều đó.
Một template few-shot prompt dùng lại được
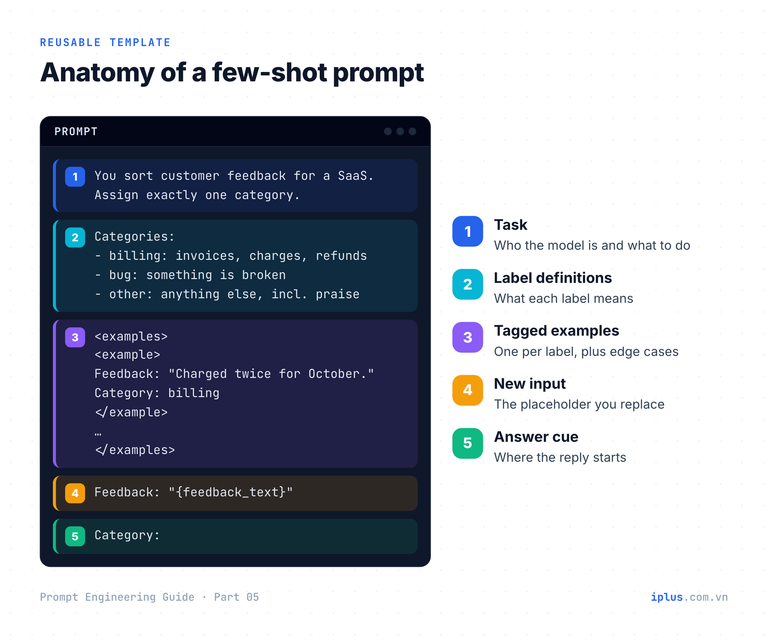
Khi một prompt đã chạy tốt, bạn sẽ dùng lại, chỉnh sửa và chuyển cho đồng nghiệp. Một bố cục cố định giúp nó dễ đọc. Bọc các ví dụ trong thẻ cũng giúp mô hình phân biệt ví dụ với instruction, điều mà hướng dẫn prompting của Anthropic khuyến nghị vì cùng lý do. Template này phân loại phản hồi của khách hàng và có kèm một trường hợp biên mà nếu không mô hình sẽ làm sai:
Bạn phân loại phản hồi của khách hàng cho một SaaS quản lý dự án.
Gán đúng một danh mục.

Danh mục:
- billing: hóa đơn, khoản bị trừ tiền, hoàn tiền, thay đổi gói
- bug: thứ từng chạy được hoặc đáng ra phải chạy được đang bị hỏng
- feature_request: yêu cầu thứ mà sản phẩm chưa làm được
- account: đăng nhập, mật khẩu, số chỗ người dùng, phân quyền
- other: mọi thứ còn lại, kể cả lời khen không kèm yêu cầu

<examples>
<example>
Feedback: "Chúng tôi bị trừ tiền hai lần cho tháng Mười."
Category: billing
</example>
<example>
Feedback: "Hãy thêm chế độ xem Gantt cho các công việc con."
Category: feature_request
</example>
<example>
Feedback: "Từ hôm qua, kéo thả giữa các board không còn hoạt động."
Category: bug
</example>
<example>
Feedback: "Đội hỗ trợ của bạn tuyệt vời trong tuần này, cảm ơn nhiều!"
Category: other
</example>
</examples>

Feedback: "{feedback_text}"
Category:
Hãy thay {feedback_text}. Với “Tôi không thêm được thành viên thứ năm, hệ thống báo đã chạm giới hạn số chỗ.” mô hình trả về:
accountKết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Giới hạn số chỗ nằm ngay ranh giới giữa billing và account. Các định nghĩa danh mục phân xử việc này, còn ví dụ lời khen ngăn mô hình ép những câu khen vào một danh mục sản phẩm.
Thực hành tốt nhất cho few-shot prompting, có nghiên cứu chứng minh
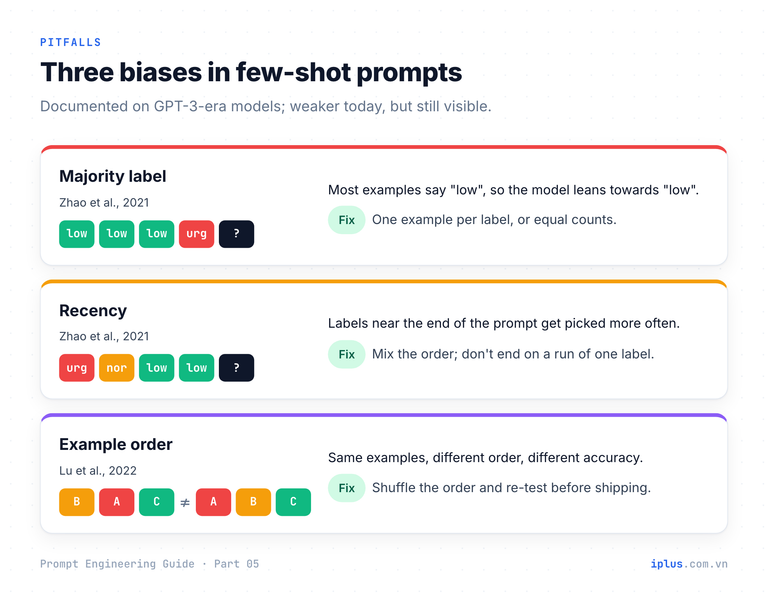
Few-shot prompting được nghiên cứu nhiều trên các mô hình thời GPT-3, và những phát hiện đó vẫn giải thích được phần lớn lỗi bạn sẽ gặp. Ba kết quả quan trọng nhất trong thực tế:
- Định dạng và không gian nhãn quan trọng hơn bạn nghĩ. Min và cộng sự (2022) phát hiện rằng việc thay ngẫu nhiên các nhãn trong phần minh họa hầu như không làm giảm hiệu năng trên các nhiệm vụ phân loại và trắc nghiệm ở 12 mô hình. Điều thúc đẩy kết quả là các ví dụ cho thấy các nhãn có thể có, loại văn bản đầu vào và định dạng tổng thể. Một nghiên cứu sau đó, Wei và cộng sự (2023), cho thấy các mô hình lớn hơn có làm theo nhãn trong ví dụ, kể cả khi nhãn bị đảo ngược. Quy tắc thực tế: làm đúng định dạng và tập nhãn, đồng thời làm cho nhãn chính xác, vì các mô hình hiện đại có học từ chúng.
- Mô hình nghiêng về một số câu trả lời nhất định. Zhao và cộng sự (2021) cho thấy độ chính xác của few-shot có thể dao động từ gần mức ngẫu nhiên đến gần mức state of the art tùy theo định dạng, cách chọn ví dụ và thứ tự, vì mô hình ưu ái các nhãn xuất hiện nhiều hoặc nằm gần cuối prompt.
- Thứ tự làm thay đổi kết quả. Lu và cộng sự (2022) phát hiện rằng cùng các ví dụ nhưng khác thứ tự có thể tạo ra khác biệt giữa hiệu năng gần state of the art và hiệu năng ngang đoán bừa, và thứ tự tốt cho mô hình này không áp dụng được cho mô hình khác.
Các mô hình hiện nay ít mong manh hơn nhiều so với GPT-3, nhưng chiều hướng của các hiệu ứng này vẫn xuất hiện trong prompt production. Sáu thói quen giúp đối phó với chúng:
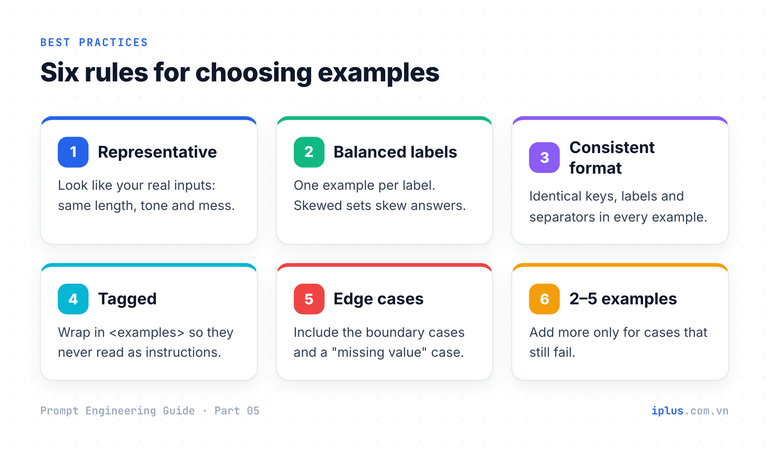
Chọn ví dụ là phần khó, và mô hình có thể giúp bạn tìm ra chỗ thiếu. Hãy dán các ví dụ của bạn vào prompt này:
Đây là các ví dụ few-shot tôi dùng để phân loại phiếu hỗ trợ:

{your_examples}

Liệt kê 5 phiếu thực tế mà các ví dụ này chưa bao quát tốt:
các trường hợp nằm gần ranh giới giữa hai nhãn, hoặc có cách diễn đạt khác thường.
Với mỗi phiếu, nêu nhãn bạn cho là phù hợp và một dòng giải thích vì sao nó khó.1. "Hóa đơn của chúng tôi hiện logo của tháng trước." Có thể là low: tài liệu thanh toán,
nhưng chỉ là lỗi hiển thị. Từ "hóa đơn" có thể kéo nó về phía urgent.
2. "Hai trong số 40 người dùng của chúng tôi không đăng nhập được." Có thể là normal: đăng nhập bị chặn,
nhưng chỉ với vài người. Ví dụ urgent của bạn nói "không ai".
3. "Xuất file chạy được nhưng CSV có định dạng ngày sai." Có thể là normal:
đầu ra sai, không có thông báo lỗi, chưa rõ cách xử lý tạm.
(đã rút gọn)Kết quả minh họa: nội dung có thể khác nhau giữa các lần chạy và các mô hình
Hãy thêm hai hoặc ba trường hợp thực tế nhất vào các ví dụ của bạn, kèm nhãn mà đội của bạn thực sự muốn. Đó là cách một few-shot prompt ngày càng tốt hơn theo thời gian.
Hạn chế, và khi nào nên dùng structured output thay thế
Few-shot prompting có những cái giá đáng biết trước khi bạn dựa vào nó trong production:
- Sao chép nội dung, không chỉ hình thức. Nếu mọi ví dụ đều nhắc đến "hóa đơn", mô hình có thể thấy hóa đơn ở nơi không có. Hãy thay đổi chủ đề, độ dài và cách diễn đạt giữa các ví dụ.
- Mẫu bề mặt. Nếu mọi ví dụ urgent đều chứa từ "lỗi", mô hình có thể học ra "lỗi = urgent". Hãy đưa vào một ví dụ urgent không có từ đó.
- Chi phí token. Các ví dụ được gửi kèm mỗi request. Mười ví dụ dài trên một bộ phân loại lưu lượng lớn sẽ cộng dồn thành chi phí đáng kể. Hãy giữ chúng ngắn và bỏ những ví dụ không làm thay đổi kết quả.
- Không đảm bảo JSON hợp lệ. Ví dụ làm cho định dạng rất có khả năng đúng, chứ không chắc chắn.
Với điểm cuối cùng đó, hãy dùng tính năng structured output của API khi code sẽ parse kết quả. Chẳng hạn, tính năng Structured Outputs của OpenAI khiến phản hồi tuân theo một JSON Schema bạn cung cấp. Schema cho bộ trích xuất hóa đơn ở trên trông như sau:
{
  "type": "object",
  "properties": {
    "vendor": { "type": "string" },
    "invoice_number": { "type": ["string", "null"] },
    "amount": { "type": "number" },
    "currency": { "type": "string", "description": "ISO 4217 code, e.g. USD" },
    "due_date": { "type": ["string", "null"], "description": "YYYY-MM-DD" }
  },
  "required": ["vendor", "invoice_number", "amount", "currency", "due_date"],
  "additionalProperties": false
}
Schema đảm bảo hình dạng; ví dụ vẫn dạy khả năng phán đoán, chẳng hạn cách đọc "30/09/2026" hay khi nào trả về null. Hãy dùng cả hai cùng nhau. Về cách ví dụ phối hợp với role, instruction và ngữ cảnh trong cùng một prompt, xem Kết hợp kỹ thuật, priming và vòng lặp cải tiến và Cấu trúc prompt: năm thành phần của một prompt.
Những lỗi thường gặp và danh sách kiểm tra
Lỗi | Điều xảy ra | Cách sửa |
|---|---|---|
Mọi ví dụ cùng một nhãn | Mô hình dự đoán nhãn đó quá nhiều | Mỗi nhãn một ví dụ, hoặc số lượng cân bằng |
Các ví dụ giống hệt nhau | Mô hình sao chép chủ đề hoặc cách diễn đạt của chúng | Thay đổi chủ đề, độ dài và cách diễn đạt |
Không bao giờ cho thấy giá trị bị thiếu | Mô hình bịa ra những giá trị nghe hợp lý | Thêm một ví dụ trả về null |
Định dạng khác nhau giữa các ví dụ | Định dạng đầu ra bị trôi | Nhãn, key và dấu phân cách giống hệt nhau |
Ví dụ mâu thuẫn với instruction | Kết quả khó đoán | Làm cho instruction và ví dụ khớp nhau |
Bỏ sót các trường hợp khó nhất | Trường hợp biên thất bại trong production | Thêm các trường hợp ranh giới thật từ dữ liệu của bạn |
Trước khi đưa một few-shot prompt vào sử dụng, hãy chạy nó trên 20 đến 30 đầu vào thật mà bạn đã gắn nhãn sẵn, sau đó xáo trộn thứ tự các ví dụ và chạy lại. Nếu kết quả thay đổi rõ rệt, các ví dụ của bạn cần được cải thiện.
Câu hỏi thường gặp
Một few-shot prompt nên có bao nhiêu ví dụ?
Thường là hai đến năm. Hãy bắt đầu với một ví dụ cho mỗi nhãn hoặc mỗi biến thể định dạng, rồi chỉ thêm ví dụ cho những trường hợp vẫn sai. Nhiều ví dụ hơn tốn token ở mỗi lần gọi và hiếm khi giúp ích thêm khi khuôn mẫu đã rõ.
Few-shot prompting có tốt hơn zero-shot không?
Không mặc nhiên. Với các nhiệm vụ phổ biến có nhãn hiển nhiên, một instruction zero-shot rõ ràng rẻ hơn và thường tốt không kém. Few-shot thắng thế khi nhãn của bạn theo quy tắc riêng, khi định dạng phải chính xác, hoặc khi một số trường hợp biên cụ thể cứ liên tục sai.
Các reasoning model có còn cần ví dụ few-shot không?
Ít hơn. OpenAI khuyên nên thử zero-shot trước với các reasoning model của họ và chỉ thêm ví dụ cho các yêu cầu đầu ra phức tạp. Anthropic lưu ý rằng các ví dụ minh họa vẫn định hình cách Claude tiếp cận những bài toán tương tự khi nó suy luận. Ví dụ vẫn là cách đáng tin cậy nhất để cố định một định dạng.
Few-shot prompting khác gì fine-tuning?
Few-shot prompting đặt ví dụ vào prompt cho mỗi request và không thay đổi gì trong mô hình. Fine-tuning huấn luyện mô hình trên nhiều ví dụ để hành vi được tích hợp sẵn. Hãy thử few-shot trước: nó có hiệu lực ngay, đổi miễn phí và đủ tốt cho hầu hết các tác vụ kinh doanh.
Nguồn và tài liệu đọc thêm
- Learn Prompting: Shot-Based Prompting (zero-shot, one-shot, few-shot)
- Brown et al. (2020), Language Models are Few-Shot Learners
- Min et al. (2022), Rethinking the Role of Demonstrations
- Zhao et al. (2021), Calibrate Before Use
- Lu et al. (2022), Fantastically Ordered Prompts and Where to Find Them
- Wei et al. (2023), Larger language models do in-context learning differently
- Anthropic: Prompting best practices (examples and XML tags)
- OpenAI: Reasoning best practices
- OpenAI: Structured Outputs
Hướng dẫn Prompt Engineering: tất cả các phần
← Trước: Phần 4: Instruction prompting và role prompting · Tiếp theo: Phần 6: Kết hợp kỹ thuật, priming và vòng lặp cải tiến →
Hãy đọc Phần 1–6 theo thứ tự: mỗi phần dựa trên phần trước. Phần 7–10 là các ứng dụng và có thể đọc theo bất kỳ thứ tự nào khi bạn đã nắm vững kiến thức nền.
- Phần 1: Prompt engineering là gì và vì sao quan trọng
- Phần 2: LLM hoạt động thế nào: kiến thức nền về generative AI
- Phần 3: Cấu trúc prompt: năm thành phần của một prompt
- Phần 4: Instruction prompting và role prompting
- Phần 5: Zero-shot, one-shot và few-shot prompting (bạn đang ở đây)
- Phần 6: Kết hợp kỹ thuật, priming và vòng lặp cải tiến
- Phần 7: Prompt cho tóm tắt, bảng biểu và phân tích tài liệu
- Phần 8: Prompt cho email, bài blog và marketing
- Phần 9: Prompt cho trợ lý lập trình
- Phần 10: Xây dựng chatbot cơ sở tri thức (RAG)
Cần hỗ trợ về chủ đề này?
Các dịch vụ của iPlus liên quan nhất đến bài viết.